Comparación de medias
Tukey, las letras y la gráfica
Tema T09 · Unidad III · Inferencia y experimentación
Comparación de medias
Tukey, las letras y la gráfica
El ANOVA dijo que algo difiere: ¿cuáles tratamientos se distinguen de verdad?
De qué trata este tema
La tabla de ANOVA dice que «al menos un tratamiento difiere», pero no cuál, y eso es lo que le importa a quien va a decidir. En este tema aprenderás a comparar todas las parejas de medias con la prueba de Tukey, sin que se acumulen las falsas alarmas. También a resumir el resultado con letras y a presentarlo en una gráfica, que es como aparece en casi cualquier reporte agronómico. Además, vas a decir por fin qué dosis de composta se distinguen en el maíz de T06 y T08.
Necesitas T07 (por qué no hacer muchas pruebas t) y T08 (la tabla de ANOVA y el CME)
Este tema T09 · Comparación de medias: Tukey, letras y gráfica
Sigue T10 · Reporte integrado del experimento
Al terminar el tema podrás:
- Explicar por qué se usa una sola regla para comparar todas las parejas.
- Calcular el HSD de Tukey con la tabla de q, con repeticiones iguales o distintas.
- Asignar las letras y leerlas sin confundir «no se detectó diferencia» con «son iguales».
- Construir la gráfica con letras y barras de error, y redactar el resultado.
Palabras clave comparación de medias prueba de Tukey HSD tabla de q letras barras de error
1. Un problema para empezar: ¿cuál soya compro?
Regresa a la soya de T07: cuatro variedades, 5 parcelas sorteadas por variedad. El ANOVA dio F = 3.51, gl = 3 y 16, p = 0.040. Se rechaza H₀: al menos una variedad difiere. El CME es 0.095.
| Variedad | V1 | V2 | V3 | V4 |
|---|---|---|---|---|
| Rendimiento medio (t/ha) | 3.2 | 3.6 | 3.0 | 3.4 |
Un productor siembra V4 y le ofrecen semilla de V2, que es más cara. V2 rinde 0.2 t/ha más. ¿Le gana de verdad, o esos 0.2 pueden ser azar? El ANOVA no contesta: sólo dice que algo difiere en algún lado. Quizá V2 sólo se distingue de V3, y la decisión del productor sigue en el aire.
2. Por qué no basta con lo que ya sabes
Ya viste en T07 que hacer una prueba t por cada pareja acumula falsas alarmas. Allá calculaste 1 − 0.95⁶ = 0.26 suponiendo comparaciones independientes. Como las parejas comparten medias, en realidad no lo son, y el valor exacto es algo menor. Pero sigue lejos del 5 % que crees estar usando:
| Tratamientos | Parejas | Falsa alarma con t de dos en dos | Con Tukey |
|---|---|---|---|
| 3 | 3 | 12 % | 5 % |
| 4 | 6 | 19 % | 5 % |
| 5 | 10 | 26 % | 5 % |
| 6 | 15 | 34 % | 5 % |
| 10 | 45 | 59 % | 5 % |
Son probabilidades de al menos una falsa alarma cuando en realidad ningún tratamiento hace nada, con 5 repeticiones. Tukey está hecha para que ese riesgo, tomando todas las parejas en conjunto, se quede en 5 %.
3. Dónde vas a usar esto
- Elegir qué sembrar o qué aplicar. Saber cuáles opciones se distinguen de verdad y cuáles no.
- Leer tablas de resultados. Las letras junto a las medias aparecen en artículos, tesis y fichas técnicas.
- Tu propio reporte. La gráfica con letras es la forma habitual de presentar un ensayo. La usarás en T10.
4. La comparación, paso a paso
4.1 La idea: una sola regla para todas las parejas
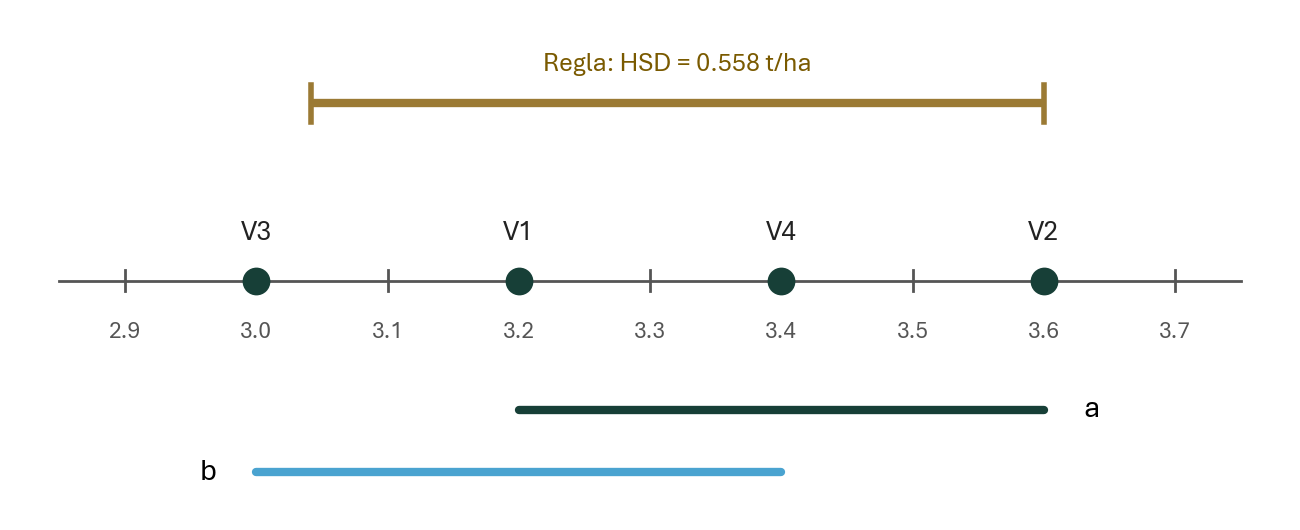
Tukey calcula una distancia, el HSD (del inglés «honest significant difference», diferencia honestamente significativa). Funciona como una regla: si dos medias están más lejos entre sí que lo que mide la regla, se declara que difieren. Si están más cerca, no se detectó diferencia.
4.2 Cómo se calcula la regla
HSD = q × √(CME ÷ n)
CME viene de la tabla de ANOVA (T08). n son las repeticiones por tratamiento. √(CME ÷ n) es el error estándar de una media, calculado con el ruido de todo el ensayo.
El valor q se busca en una tabla, porque Excel no tiene una función para calcularlo. Depende del número de tratamientos (t) y de los grados de libertad del error. Crece con t: entre más medias hay, más lejos quedan por puro azar la mayor y la menor, y la regla debe alargarse para no dar falsas alarmas.
| gl del error | t = 2 | t = 3 | t = 4 | t = 5 | t = 6 |
|---|---|---|---|---|---|
| 6 | 3.46 | 4.34 | 4.90 | 5.30 | 5.63 |
| 8 | 3.26 | 4.04 | 4.53 | 4.89 | 5.17 |
| 10 | 3.15 | 3.88 | 4.33 | 4.65 | 4.91 |
| 12 | 3.08 | 3.77 | 4.20 | 4.51 | 4.75 |
| 14 | 3.03 | 3.70 | 4.11 | 4.41 | 4.64 |
| 15 | 3.01 | 3.67 | 4.08 | 4.37 | 4.59 |
| 16 | 3.00 | 3.65 | 4.05 | 4.33 | 4.56 |
| 18 | 2.97 | 3.61 | 4.00 | 4.28 | 4.49 |
| 20 | 2.95 | 3.58 | 3.96 | 4.23 | 4.45 |
| 24 | 2.92 | 3.53 | 3.90 | 4.17 | 4.37 |
| 30 | 2.89 | 3.49 | 3.85 | 4.10 | 4.30 |
| 40 | 2.86 | 3.44 | 3.79 | 4.04 | 4.23 |
| 60 | 2.83 | 3.40 | 3.74 | 3.98 | 4.16 |
Valores de q para α = 0.05. Si tus gl no aparecen, usa el renglón inmediato inferior: la regla queda un poco más larga, del lado seguro.
Con la soya: t = 4 y gl = 16, así que q = 4.05. El error estándar es √(0.095 ÷ 5) = 0.1378, y el HSD = 4.05 × 0.1378 = 0.558 t/ha.
Cuidado: en q se usa el número de tratamientos (4), no los gl de tratamientos (3). Es el error más común al leer la tabla.
4.3 Comparar todas las parejas
Con 4 tratamientos hay 6 parejas. Cada diferencia se compara con 0.558. Sumando y restando el HSD a la diferencia se obtiene además su intervalo de confianza, que dice qué tan grande podría ser en realidad:
| Pareja | Diferencia | ¿Llega al HSD? | Intervalo de 95 % |
|---|---|---|---|
| V2 − V4 | 0.2 | No | −0.36 a 0.76 |
| V2 − V1 | 0.4 | No | −0.16 a 0.96 |
| V2 − V3 | 0.6 | Sí | 0.04 a 1.16 |
| V4 − V1 | 0.2 | No | −0.36 a 0.76 |
| V4 − V3 | 0.4 | No | −0.16 a 0.96 |
| V1 − V3 | 0.2 | No | −0.36 a 0.76 |
Ahora sí se contesta el problema. Sólo V2 y V3 se distinguen. V2 no se separa de V4: su diferencia de 0.2 t/ha no llega a la regla. Pero mira el intervalo: va de −0.36 a 0.76. No prueba que sean iguales: V2 podría rendir hasta 0.76 t/ha más. Este ensayo no alcanza para saberlo.
4.4 Las letras
Con más tratamientos, una tabla de parejas se vuelve larga. Las letras resumen lo mismo en una columna. Se asignan así:
- Ordena las medias de mayor a menor.
- Primera línea: empieza en la mayor y traza una línea hasta la última media que no difiere de ella. Todas las de esa línea llevan la letra a.
- Siguiente media: baja una media y traza su línea de la misma forma. Si queda toda adentro de una línea anterior, no aporta nada y se descarta. Si llega más abajo, lleva una letra nueva.
- Repite hasta llegar a la última media.
Con la soya (HSD = 0.558): desde V2 = 3.6, la línea llega hasta V1 = 3.2, porque V3 ya está a 0.6. Esa es la a. Desde V4 = 3.4, llega hasta V3 = 3.0: rebasa a la anterior, y es la b. Desde V1 = 3.2, llega también a V3: esa línea queda dentro de la b, y se descarta.
| Variedad | Media (t/ha) | Letras |
|---|---|---|
| V2 | 3.6 | a |
| V4 | 3.4 | ab |
| V1 | 3.2 | ab |
| V3 | 3.0 | b |
Cómo se lee. Dos medias que comparten una letra no se pudieron separar. Dos medias sin letra en común difieren. V2 (a) y V3 (b) difieren. V4 (ab) no difiere de ninguna.
V4 no difiere de V2, ni de V3, aunque V2 y V3 sí difieren entre sí. No es una contradicción: no detectar una diferencia no es probar que no existe, como viste en T04. Por eso no escribas «V2 y V4 son iguales», sino «no se detectó diferencia entre V2 y V4».
Prueba Mueve las medias y mira la regla Empieza con la soya de la lectura. Mueve las medias, el CME y las repeticiones, y mira qué pasa con la regla y con las letras. Después cambia de Tukey a t de dos en dos: la regla se acorta, y suben las falsas alarmas.
4.5 La gráfica y la redacción
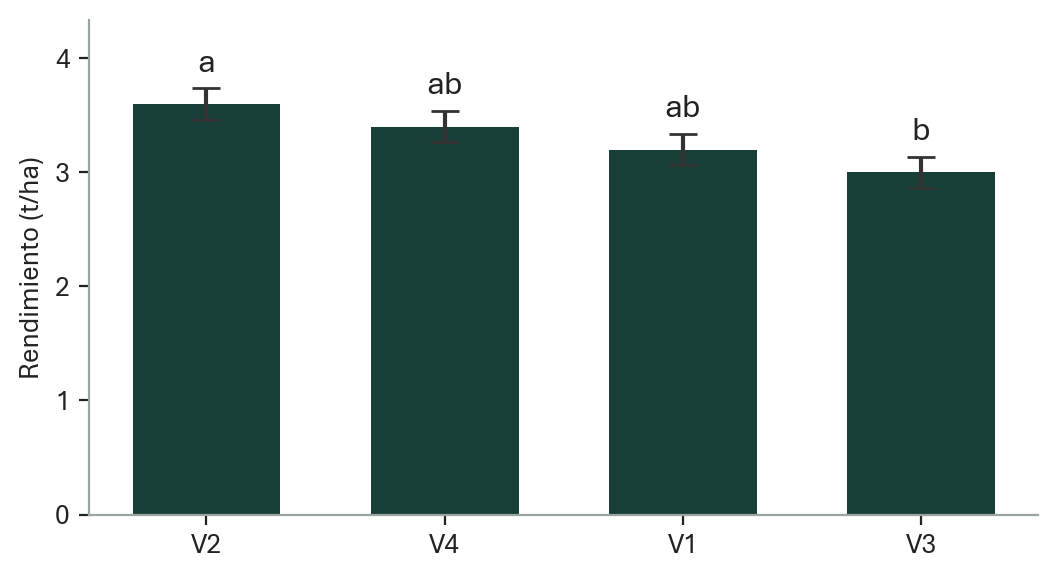
Una gráfica de comparación de medias lleva estas cosas:
- El eje vertical empieza en cero. Las columnas comparan por su altura, y si cortas el eje exageran las diferencias.
- Las barras de error dicen qué son. Error estándar, desviación estándar o intervalo se ven igual y no significan lo mismo. Si no lo dices, no se puede leer.
- El pie explica las letras y da la prueba y el α.
- Las unidades en el eje.
Cómo se comunica: «El rendimiento difirió entre variedades (F = 3.51, gl = 3 y 16, p = 0.040). V2 rindió 0.6 t/ha más que V3 (Tukey, HSD = 0.56 t/ha); V1 y V4 no se distinguieron de ninguna de las dos».
Y si F no rechazó, no se sacan letras. En este curso, primero la tabla de ANOVA y sólo si rechaza se comparan medias. Los ovinos de T07 (p = 0.125) se quedan sin letras: se informa que no se detectaron diferencias.
4.6 Ejemplo resuelto: el ajo, con repeticiones distintas
Si las n son distintas, ya no hay una sola regla: cada pareja tiene la suya. Se llama ajuste de Tukey-Kramer, y con n iguales da justo la fórmula de antes:
HSD = q × √( (CME ÷ 2) × (1/nᵢ + 1/nⱼ) )
nᵢ y nⱼ son las repeticiones de las dos medias que estás comparando.
En el ajo de T08 quedaron n = 5, 4, 4 parcelas, con medias de 9, 11, 10 t/ha. La tabla dio CME = 0.6, gl = 10 y p = 0.011.
- Busca q: t = 3 y gl = 10, q = 3.88.
- P2 − P1 (n = 4 y 5): 3.88 × √(0.3 × (1/4 + 1/5)) = 1.426. La diferencia es 2, y sí llega.
- P2 − P3 (n = 4 y 4): 3.88 × √(0.3 × (1/4 + 1/4)) = 1.503. La diferencia es 1, y no llega.
- P3 − P1 (n = 4 y 5): la misma regla de 1.426. La diferencia es 1, y no llega.
- Letras: P2 a, P3 ab, P1 b.
Cómo se comunica: «El programa P2 rindió 2 t/ha más que P1 (Tukey, α = 0.05); P3 no se distinguió de ninguno de los dos. Se perdieron una parcela de P2 y una de P3».
En Excel. «Análisis de datos» hace la tabla de ANOVA, pero no hace Tukey. Por eso armarás la comparación con fórmulas y tomarás q de la tabla.
Estadísticas > ANOVA > Un solo factor, botón Comparaciones, marca Tukey (en inglés, Stat > ANOVA > One-Way > Comparisons > Tukey). Te da las letras en «Información de agrupación» y los intervalos en «Pruebas simultáneas». Ajusta solo si las n son distintas. Puede diferir un poco de tu cuenta, porque no redondea q.
4.7 Lo que se gana y lo que se pierde
Se gana una respuesta concreta con las falsas alarmas bajo control. A cambio, la regla es más larga que la de una t suelta, así que se escapan diferencias reales pequeñas. A veces F rechaza y ninguna pareja llega a la regla: es raro, y se reporta tal cual.
Hay otras pruebas, como DMS, Duncan o Dunnett (que compara sólo contra un testigo). Más permisivas o más estrictas, responden lo mismo con otro equilibrio de riesgos. La prueba se elige antes de ver los datos, no probando hasta que salga lo que uno quiere.
Además, Tukey trata a los tratamientos como categorías. Si son dosis, ignora que 10 está entre 5 y 15. Una curva de respuesta puede aprovechar esa información, como verás con la regresión en U4.
¿Lo entendiste? Cuatro preguntas rápidas No cuentan para la calificación. Elige una respuesta para ver la explicación; puedes volver a intentar.
1. Un ensayo tiene 4 tratamientos y 20 grados de libertad en el error. ¿Qué valor de q se usa?
- q(3, 20) = 3.58
- q(4, 20) = 3.96
- q(4, 16) = 4.05
q se busca con el número de tratamientos (4) y los gl del error (20). No se usan los gl de tratamientos.
2. Con q = 4, CME = 9 y n = 4, ¿cuánto vale el HSD?
- 6
- 9
- 3
HSD = 4 × √(9 ÷ 4) = 4 × 1.5 = 6. Las medias que estén a 6 o más se declaran diferentes.
3. Las medias quedaron así: A (a), B (ab), C (b). ¿Qué se concluye?
- A y C difieren; B no se distingue de ninguna
- Las tres difieren entre sí
- A y B son iguales, y B y C son iguales
Sin letra en común, difieren: A y C. B comparte letra con las dos: no se pudo separar de ninguna, lo que no es lo mismo que decir que son iguales.
4. El ANOVA dio p = 0.30. ¿Qué sigue?
- Sacar las letras con Tukey
- Reportar que no se detectaron diferencias
- Hacer pruebas t de dos en dos
Si F no rechaza, en este curso no se comparan medias. Hacer t de dos en dos sería buscar una diferencia con más falsas alarmas.
5. Lo que harás
Excel del Tema T09 · 2 hojas
Guárdalo como U3-T09_Apellido_Nombre.xlsx y escribe sólo en las celdas amarillas.
Las letras a mano (hoja 1_Letras_a_mano)
Caso A: cebolla. Las densidades de T07, que quedaron sin comparar. De las parejas a las letras.
Caso B: pepino. Cinco híbridos, donde salen tres letras.
Caso C: melón. El ensayo de T08, con repeticiones distintas.
Para qué te sirve hacerlo a mano. Es lo que se pide en un examen en papel, y asignar las letras tú mismo es lo que te permite leerlas sin equivocarte.
- Escribe tu nombre y la fecha.
- Caso A. Busca q en la tabla de la sección 4.2 y calcula el HSD. Anota cada diferencia, decide si llega y asigna las letras, de mayor a menor.
- Caso B. Ordena primero los híbridos. Usa las líneas de la sección 4.4.
- Caso C. Calcula un HSD para cada pareja, como en la sección 4.6.
- Contesta las Preguntas 1 y 2.
En el Caso A, el HSD da alrededor de 7 t/ha, y sólo una pareja llega. Si te salen más, revisa si usaste t = 4 en q.
Comparación y gráfica en Excel (hoja 2_Letras_Excel)
El caso: el maíz con cuatro dosis de composta de T06, con la tabla de ANOVA que armaste en T08 (F = 6.34, p = 0.005).
Para qué: Excel hace las cuentas de todas las parejas, y sólo tú decides las letras. Al final tendrás la gráfica de tu reporte de T10.
- Paso 1 · Resumen. Bajo cada columna calcula n con
=CONTAR(B7:B11), la media con=PROMEDIO(B7:B11)y s² con=VAR.S(B7:B11). Copia a la derecha. - Paso 2 · La regla. Calcula t con
=CONTAR(B13:E13), los gl del error con=SUMA(B12:E12)-H6 y el CME con=SUMAPRODUCTO(B12:E12-1,B14:E14)/H7. Debe darte el mismo CME de T08. Escribe q de la tabla de la lectura, porque Excel no lo calcula. Después, el error estándar con=RAIZ(H8/B12)y el HSD con=H9*H10. - Paso 3 · Las parejas. En cada renglón calcula la diferencia: el primero es
=C13-B13, y los demás según la pareja de la columna J. Decide con=SI(K7>=$H$11,"Sí","No"), y saca el intervalo con=K7-$H$11y=K7+$H$11. Copia esas tres fórmulas hacia abajo. - Paso 4 · Ordena y pon letras. La media del lugar 1 es
=K.ESIMO.MAYOR($B$13:$E$13,A18), y su tratamiento es=INDICE($B$6:$E$6,COINCIDIR(C18,$B$13:$E$13,0)). Copia hacia abajo. Las letras las escribes tú, mirando el Paso 3. La etiqueta es=B18&” “&D18. - Paso 5 · La gráfica. Selecciona las etiquetas E18:E21 y, con Ctrl, las medias C18:C21. Insertar > Gráfico de columnas. Quita la leyenda, y pon el título del eje: Rendimiento (t/ha). Con Elementos de gráfico (+) > Barras de error > Más opciones elige Valor fijo y escribe tu error estándar. No uses la opción «Error estándar» de ese menú: calcula otra cosa. Escribe el pie en la celda que está debajo de la gráfica.
- Paso 6 · Responde las Preguntas 3 a 6.
Tu Excel puede usar punto y coma ( ; ) en lugar de coma ( , ). En inglés: K.ESIMO.MAYOR = LARGE, COINCIDIR = MATCH, INDICE = INDEX, SUMAPRODUCTO = SUMPRODUCT, RAIZ = SQRT, SI = IF, SUMA = SUM, CONTAR = COUNT, PROMEDIO = AVERAGE.
Si quieres las letras encima de las columnas: en Excel de escritorio, agrega etiquetas de datos y, en sus opciones, marca «Valor de las celdas» y elige las letras. Si no aparece, haz clic en cada etiqueta y escribe la letra.
6. Antes de entregar
Marca cada punto conforme lo revises. Tus marcas se guardan sólo en este navegador.