De la muestra a la población
Por qué cada muestra da un resultado distinto y cuánto se puede confiar en él
Tema T01 · Unidad III · Inferencia y experimentación
De la muestra a la población
Por qué cada muestra da un resultado distinto y cuánto se puede confiar en él
Dos técnicos midieron el mismo lote y sacaron números distintos: ¿quién se equivocó?
De qué trata este tema
En las Unidades I y II aprendiste a describir datos y a calcular probabilidades cuando ya conoces la media y la desviación estándar de la población. En el trabajo real casi nunca es así: no puedes pesar todos los animales ni cosechar todas las parcelas. Mides una muestra y quieres decir algo sobre todos. A eso se le llama inferencia, y es de lo que trata esta unidad. Este primer tema responde la pregunta que lo sostiene todo: si cada muestra da un resultado distinto, ¿cuánto suele alejarse ese resultado de la verdad?
Necesitas Unidad I (población, muestra, media y desviación estándar) y Unidad II (normal y puntuación z). T10 de la Unidad II ayuda, pero no es indispensable
Este tema T01 · De la muestra a la población
Sigue T02 · Intervalos de confianza para una media
Al terminar el tema podrás:
- Distinguir un parámetro de un estadístico y usar los símbolos de cada uno.
- Explicar qué es una distribución muestral y por qué las medias varían menos que los datos.
- Calcular e interpretar el error estándar de una media, y predecir qué le pasa al cambiar n.
- Explicar por qué una muestra más grande no corrige una muestra mal elegida.
Palabras clave inferencia parámetro estadístico variación muestral distribución muestral error estándar teorema del límite central
1. Un problema para empezar: ¿quién se equivocó?
Dos técnicos estiman el rendimiento del mismo lote de 40 ha de maíz. Cada uno cosecha 9 parcelas elegidas al azar. El técnico A obtiene 9.2 t/ha y el técnico B, 9.9 t/ha. El productor se molesta: «¿Cuál de los dos está mal?».
Probablemente ninguno. Cada uno midió parcelas distintas, así que era de esperarse que sacaran números distintos. Lo que hay que preguntarse es otra cosa: ¿cuánto suelen diferir las medias de 9 parcelas? Si las parcelas varían con s = 1.2 t/ha, las medias de 9 parcelas varían alrededor de 1.2 ÷ √9 = 0.4 t/ha. Una diferencia de 0.7 t/ha entre dos técnicos es completamente normal. Con este número, el productor deja de pelear con sus técnicos y puede preguntarse si necesita más parcelas.
2. Por qué no basta con lo que ya sabes
En la Unidad I calculabas la media de una muestra y ahí terminaba todo: describías lo que mediste. En la Unidad II, los problemas te daban μ y σ como si alguien los conociera. Ahora la situación se invierte: conoces la muestra y no conoces la población. Para pasar de una a la otra hace falta saber cómo se comporta la media de una muestra cuando se repite el muestreo, y eso no sale de ninguna fórmula de las unidades anteriores.
3. Dónde vas a usar esto
- Estimar rendimiento antes de la cosecha. Con unas parcelas se estima todo el lote, y se dice con qué precisión.
- Decidir cuánto muestrear. Cuántos animales pesar o cuántas parcelas cosechar para alcanzar la precisión que necesitas.
- Leer reportes. Las barras de error de las gráficas y el «± 0.4» de una tabla suelen ser errores estándar.
- Todo lo que sigue. Intervalos de confianza (T02), pruebas de hipótesis (T03) y ANOVA (T07) se construyen sobre el error estándar.
4. Parámetro, estadístico y error estándar
4.1 Parámetro y estadístico
Un parámetro es un número que describe a la población: es fijo, pero casi siempre desconocido. Un estadístico es un número que se calcula con la muestra: se conoce, pero cambia de una muestra a otra. Usamos el estadístico para estimar el parámetro.
| Qué mide | Parámetro (población) | Estadístico (muestra) |
|---|---|---|
| Media | μ | x̄ |
| Desviación estándar | σ | s |
| Proporción | p | p̂ (se lee «p gorro») |
Truco para no confundirlos: pregúntate si ese número ya se pudo calcular con lo que se midió. Si sí, y lo medido es sólo una parte, es un estadístico. Si habla de todos y no se midió a todos, es un parámetro. Si se midió a toda la población que interesa (un censo), lo que resulta es directamente el parámetro: no hay nada que inferir.
4.2 Cada muestra da un resultado distinto
Ya lo viste en la Clase 02: dos muestras al azar del mismo lote casi nunca dan lo mismo. Eso se llama variación muestral, y no es un error de nadie. El estadístico es, entonces, una variable aleatoria: tiene su propia distribución, igual que las de la Unidad II.
4.3 La distribución muestral
La distribución muestral de la media es la distribución de todas las medias que se obtendrían al repetir el muestreo. Con una población diminuta se puede ver completa. Imagina 4 estanques con mortalidades de 2, 4, 6 y 8 % (μ = 5 %) y muestras de 2 estanques. Hay 6 muestras posibles:
| Muestra | 2 y 4 | 2 y 6 | 2 y 8 | 4 y 6 | 4 y 8 | 6 y 8 |
|---|---|---|---|---|---|---|
| x̄ (%) | 3 | 4 | 5 | 5 | 6 | 7 |
Fíjate en dos cosas. Primera: el promedio de esas 6 medias es (3 + 4 + 5 + 5 + 6 + 7) ÷ 6 = 5, exactamente μ: la media muestral no se inclina hacia ningún lado. Segunda: los datos iban de 2 a 8, pero las medias sólo van de 3 a 7: las medias varían menos que los datos, porque un valor alto y uno bajo se compensan.
4.4 El error estándar
La desviación estándar de esa distribución de medias tiene nombre propio: error estándar. Mide cuánto suele alejarse una media muestral de μ.
Error estándar de la media = σ ÷ √n, y como σ casi nunca se conoce, se estima con s ÷ √n
No es un «error» de medición ni una equivocación: es la variación natural del promedio de una muestra de tamaño n.
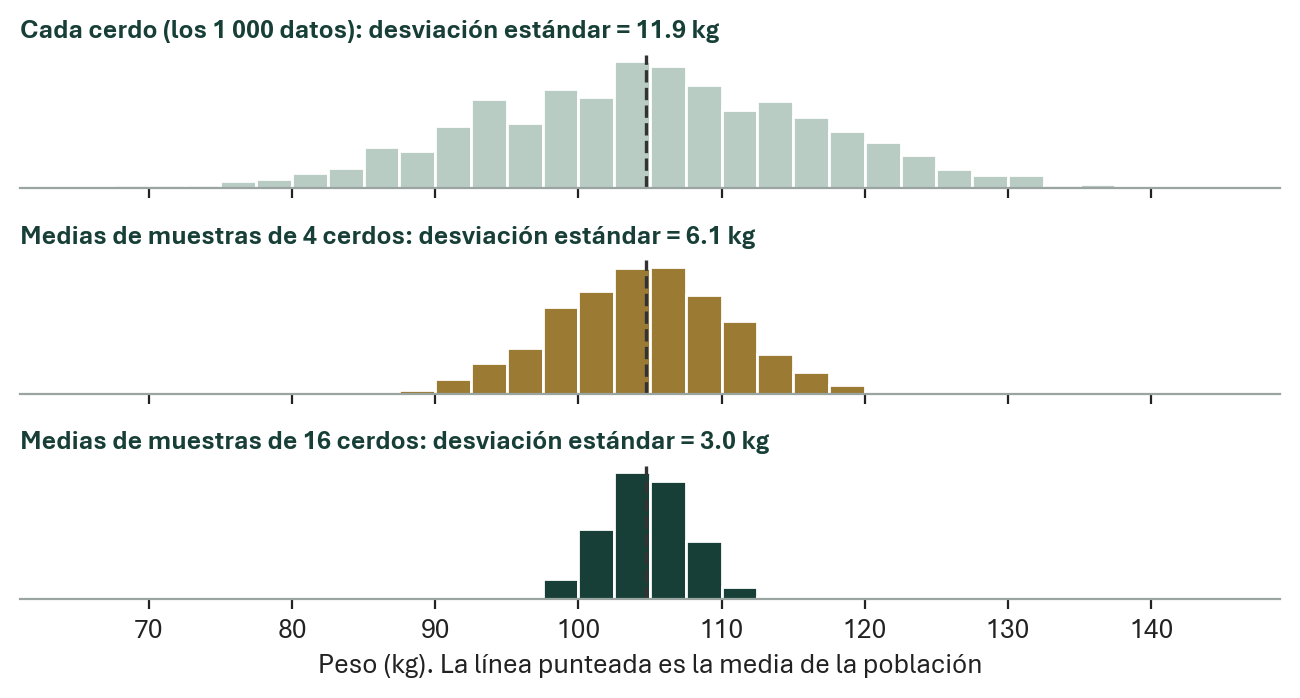
No confundas s con el error estándar. s dice cuánto varían los animales; el error estándar dice cuánto variaría el promedio si repitieras el estudio. Si pesas más animales, s se queda más o menos igual, porque los animales no se vuelven más parecidos, pero el error estándar baja.
Por el √n, la precisión cuesta cara. Para reducir el error estándar a la mitad necesitas cuatro veces más datos. Con s = 10 kg: n = 25 da 2 kg, n = 100 da 1 kg y n = 400 da 0.5 kg.
4.5 La forma: las medias tienden a la campana
Hay un resultado sorprendente, llamado teorema del límite central: aunque los datos originales estén muy sesgados, las medias de muestras suficientemente grandes siguen aproximadamente una normal. Como regla práctica, con n de 30 o más suele bastar; si los datos ya son casi simétricos, alcanza con bastante menos.
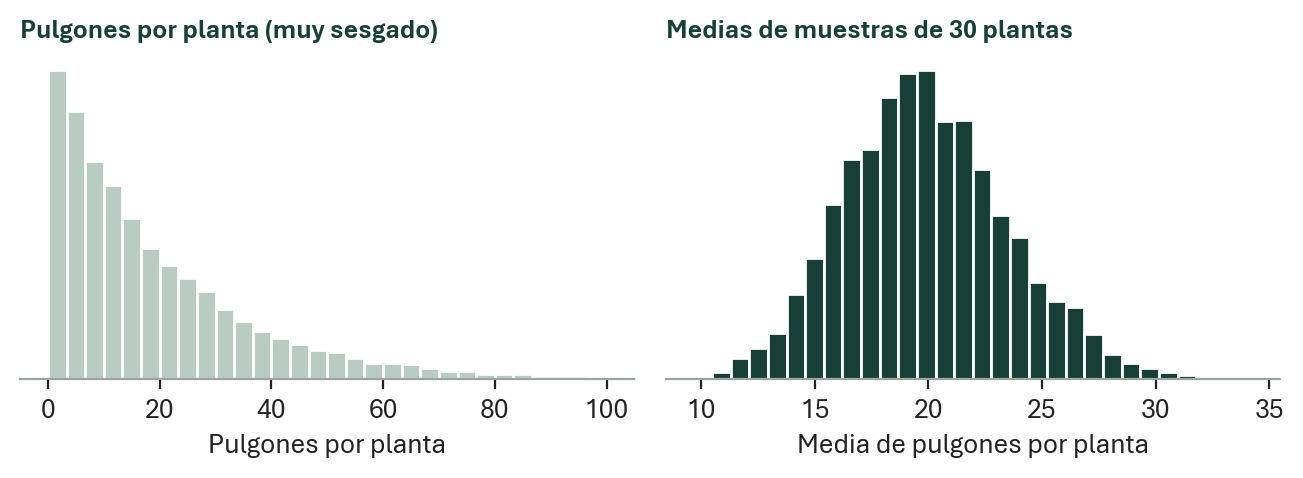
Por eso en la Unidad II la normal importaba tanto: gracias a este teorema, lo que aprendiste de áreas y de z sirve también para hablar de promedios. En particular, cerca del 95 % de las medias cae a menos de 2 errores estándar de μ.
Prueba Saca muestras y acumula sus medias Dos poblaciones simuladas, distintas de la del Excel. Elige n, saca muestras y compara cómo se reparten las medias contra los datos originales.
4.6 Ejemplo resuelto: corderos de un rancho
Un rancho quiere saber el peso promedio de sus 800 corderos. Pesa 25 corderos al azar: x̄ = 31.4 kg y s = 5 kg.
- Parámetro y estadístico: el parámetro es μ, el peso promedio de los 800. El estadístico que lo estima es x̄ = 31.4 kg.
- Error estándar: 5 ÷ √25 = 5 ÷ 5 = 1.0 kg.
- Qué tan lejos puede estar: cerca del 95 % de las medias queda a menos de 2 errores estándar de μ. Entonces μ debe andar entre 31.4 − 2 y 31.4 + 2, es decir, 29.4 a 33.4 kg. (En T02 harás este cálculo con precisión.)
- Y con más corderos: para bajar el error estándar a 0.5 kg, n debe ser 4 veces mayor: 100 corderos.
Cómo se comunica: «Los 25 corderos pesados promediaron 31.4 kg. Por el tamaño de la muestra, el promedio del rancho debe estar a unos 2 kg de ese valor».
4.7 Lo que se gana y lo que se pierde
Con el error estándar puedes decir qué tan precisa es una estimación sin repetir el estudio: basta con una muestra. A cambio, todo esto supone que la muestra es aleatoria. El error estándar mide la variación del azar, no el sesgo. Si pesas sólo los corderos más fáciles de atrapar, con 10 000 tendrás un error estándar diminuto y una estimación igual de equivocada. Más datos no corrigen una mala selección.
¿Lo entendiste? Cuatro preguntas rápidas No cuentan para la calificación. Elige una respuesta para ver la explicación; puedes volver a intentar.
1. Pesas 30 corderos de un rancho de 800 y calculas su promedio. Ese promedio es…
- Un parámetro
- Un estadístico
- La media de la población
Se calculó con la muestra, así que es un estadístico (x̄). El parámetro es μ, el promedio de los 800, que no se conoce.
2. Con s = 20 kg y n = 25, ¿cuánto vale el error estándar?
- 0.8 kg
- 4 kg
- 20 kg
20 ÷ √25 = 20 ÷ 5 = 4 kg. Dividir entre 25 sin sacar raíz da 0.8, que es el error más común.
3. Si pasas de 25 a 100 parcelas, el error estándar…
- Baja a la mitad
- Baja a la cuarta parte
- No cambia
n se multiplicó por 4 y √n por 2: el error estándar se divide entre 2. La precisión cuesta cara: el doble de precisión pide cuatro veces más datos.
4. Un técnico pesa 500 cerdos del corral junto a la báscula. ¿Qué le pasa a la estimación del promedio de la granja?
- Queda bien, porque 500 son muchos
- Tiene poco error estándar, pero puede tener sesgo
- No tiene ningún problema si calcula s
El error estándar sólo mide la variación del azar. Si ese corral es distinto del resto, la estimación queda desviada aunque la muestra sea enorme.
5. Lo que harás
Excel del Tema T01 · 2 hojas
Guárdalo como U3-T01_Apellido_Nombre.xlsx y escribe sólo en las celdas amarillas.
Parámetros, muestras y error estándar a mano (hoja 1_Muestra_a_mano)
Caso A: ¿parámetro o estadístico? Seis afirmaciones.
Caso B: cinco colmenas. Un apiario tiene 5 colmenas que produjeron 10, 14, 18, 22 y 26 kg de miel (μ = 18 kg). Se toman todas las muestras posibles de 2 colmenas.
Caso C: error estándar. Con s = 12 kg, cuatro tamaños de muestra.
Para qué te sirve hacerlo a mano. Al escribir las 10 medias verás con tus propios ojos una distribución muestral completa, algo que en una población real nunca se puede ver.
- Escribe tu nombre y la fecha.
- Caso A. Elige Parámetro o Estadístico.
- Caso B. Calcula la media de cada muestra, el promedio de las 10 medias, cuántas dan exactamente 18 kg y la probabilidad de equivocarse por más de 4 kg.
- Caso C. Calcula √n y el error estándar. Después, el n necesario para que el error estándar sea de 1.5 kg.
- Contesta las Preguntas 1 y 2.
En el Caso B, el promedio de las 10 medias debe dar exactamente μ = 18 kg. En el Caso C, cuando n se multiplica por 4, el error estándar debe bajar a la mitad.
Treinta muestras en Excel (hoja 2_Medias_Excel)
El caso: una granja tiene el registro completo de 1 000 cerdos, con μ = 104.7 kg y σ = 11.9 kg. Para ver qué pasa al muestrear, ya se sacaron al azar 30 muestras de 16 cerdos, una por renglón. Para las muestras de 4, usarás los primeros 4 cerdos de cada renglón.
Para qué: verás en datos reales que las medias de 16 se agrupan más cerca de μ que las de 4, y comprobarás que σ ÷ √n predice cuánto varían.
- Paso 1 · Las medias. La primera fila ya tiene las fórmulas de modelo:
=PROMEDIO(B8:E8)para n = 4 y=PROMEDIO(B8:Q8)para n = 16. Cópialas hacia abajo hasta la muestra 30. - Paso 2 · Resumen. En cada columna calcula el promedio de las 30 medias (
=PROMEDIO), su desviación estándar (=DESVEST.M), el error estándar teórico (σ ÷ √n), el mínimo (=MIN), el máximo (=MAX) y cuántas medias quedaron a 5 kg o menos de μ (con=CONTAR.SI.CONJUNTO). Los valores de μ y σ están arriba de la tabla, en las celdas O5 y T5. - Paso 3 · Si sólo tuvieras la muestra 1. Con los 16 datos del primer renglón calcula x̄, s, el error estándar (s ÷ √16) y el rango x̄ ± 2 errores estándar.
- Paso 4 · Responde las Preguntas 3 a 6.
Tu Excel puede usar punto y coma ( ; ) en lugar de coma ( , ). En inglés: PROMEDIO = AVERAGE, DESVEST.M = STDEV.S, CONTAR.SI.CONJUNTO = COUNTIFS, RAIZ = SQRT.
6. Antes de entregar
Marca cada punto conforme lo revises. Tus marcas se guardan sólo en este navegador.