Prueba estadística
Diferencia de medias, intervalo de confianza y valor p
2026-11-05
Tema II.3 · Unidad II · Calidad de la información
Prueba estadística
Diferencia de medias, intervalo de confianza y valor p
¿Conviene sembrar temprano?
Escucha primero
Si quieres una primera idea antes de leer, estos audios cuentan de qué trata el tema en unos 5 minutos. Son opcionales, y la página se entiende sin ellos. La voz es generada por computadora.
De qué trata
Con la distribución normal aprendiste a decir si un dato es raro. Muchas decisiones comparan dos grupos: dos fechas de siembra, dos dietas, dos sustratos. Sus promedios casi nunca salen iguales, aunque los tratamientos sean equivalentes. Una prueba estadística ayuda a decidir si la diferencia es más grande de lo que el azar explicaría por sí solo.
Antes · Tema II.2 Distribución normal ¿Qué es normal y qué es raro?
Este tema · II.3 Prueba estadística ¿La diferencia es real?
Después · Tema II.4 Correlación y regresión ¿Cuánto rinde cada kilo de nitrógeno?
Al terminar este tema podrás:
- Plantear la hipótesis nula y la hipótesis alternativa de una comparación entre dos grupos.
- Calcular a mano la diferencia de medias, su error estándar y el estadístico t.
- Leer en la salida de R la diferencia, el intervalo de confianza y el valor p.
- Explicar por qué el volumen de datos cambia la conclusión.
- Distinguir entre significativo, causal e importante en la práctica.
Palabras clave hipótesis nula hipótesis alternativa error estándar prueba t intervalo de confianza valor p significancia volumen de datos variable de confusión
1. El problema: ¿conviene sembrar temprano?
Una asociación de productores de trigo del Valle del Yaqui quiere recomendar una fecha de siembra. Un socio revisó las primeras 8 parcelas de la libreta y encontró esto:
4 parcelas tempranas 6.58 t/ha Promedio de rendimiento
4 parcelas tardías 6.96 t/ha Promedio de rendimiento
Su conclusión: «Conviene sembrar tarde»
El cálculo está bien, pero ¿basta con eso? Si tomara otras 8 parcelas, los promedios cambiarían, y quizá hasta se invertirían. Hace falta medir cuánto puede moverse una diferencia sólo por azar.
2. Por qué no basta comparar dos promedios
Las dos figuras muestran grupos cuyas medias están separadas exactamente por 1 t/ha. A la izquierda los datos varían poco y los grupos casi no se enciman. A la derecha varían mucho: una diferencia de 1 t/ha se pierde entre las parcelas.
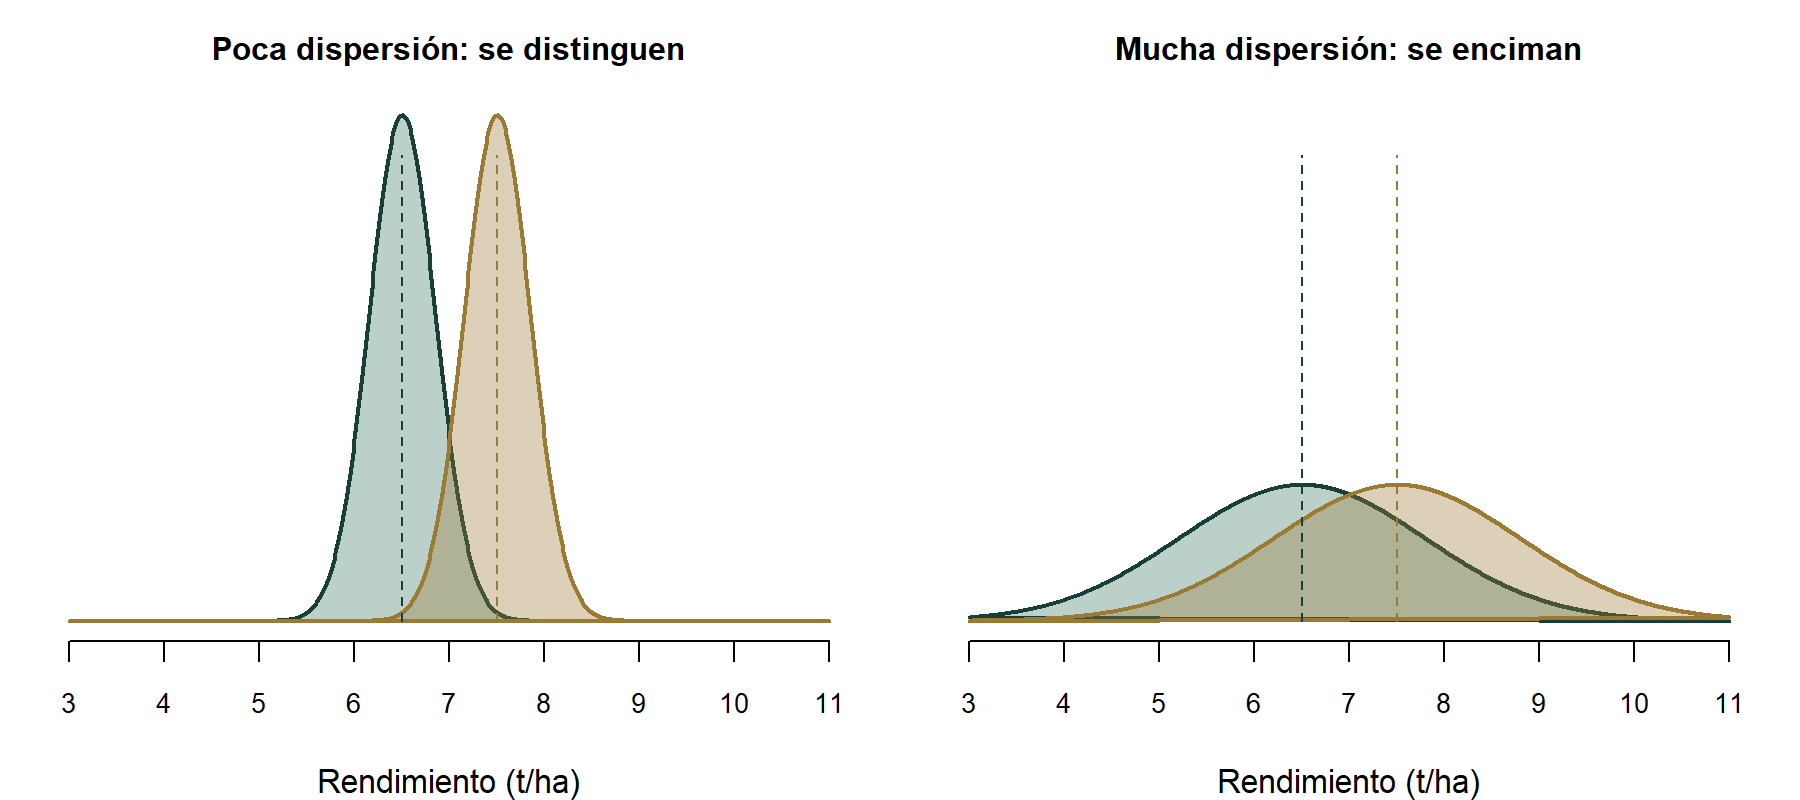
Por eso una comparación necesita tres cosas: cuánto difieren las medias, cuánto varían los datos y cuántos datos hay.
3. La prueba paso a paso
3.1 Las dos hipótesis
Una prueba parte de dos afirmaciones que compiten:
| Hipótesis | Qué afirma | En el trigo |
|---|---|---|
| Nula (H₀) | No hay diferencia entre los grupos; lo observado se debe al azar | El rendimiento medio es igual en ambas siembras |
| Alternativa (H₁) | Sí hay diferencia entre los grupos | El rendimiento medio es distinto |
La prueba no demuestra que una sea verdadera. Pregunta si los datos son difíciles de explicar suponiendo que H₀ es cierta.
3.2 El error estándar de la diferencia
Si repitieras el estudio con otras parcelas, la diferencia de medias cambiaría. El error estándar (EE) estima cuánto suele moverse. Crece con la dispersión de los datos y baja cuando hay más datos.
EE = √( s₁²/n₁ + s₂²/n₂ )
s₁ y s₂ son las desviaciones estándar de cada grupo; n₁ y n₂, sus tamaños. Va en las mismas unidades que los datos.
No confundas la desviación estándar, que dice cuánto varían las parcelas, con el error estándar, que dice cuánto varía la diferencia de medias entre un estudio y otro.
3.3 El estadístico t: señal entre ruido
t = diferencia de medias ÷ EE
Dice cuántos errores estándar mide la diferencia. No tiene unidades. Como guía, cuando hay bastantes datos, |t| mayor que 2 ya es difícil de atribuir al azar.
Esta versión, que no supone que los dos grupos varían igual, se llama prueba t de Welch. Es la que hace R de manera predeterminada.
3.4 El intervalo de confianza
La diferencia que calculas es una estimación. El intervalo de confianza al 95 % da un rango de valores compatibles con los datos para la diferencia real:
IC 95 % = diferencia ± multiplicador × EE
El multiplicador se acerca a 2 cuando hay muchos datos y crece cuando hay pocos: con 4 + 4 datos es cerca de 2.45. R lo calcula por ti.
Cómo leerlo: si el intervalo no incluye el 0, los datos apuntan a una diferencia real, y sus extremos dicen qué tan grande podría ser. Si incluye el 0, los datos no permiten descartar que no haya diferencia.
3.5 El valor p
Valor p
Si en realidad no hubiera diferencia (H₀ cierta), es la probabilidad de obtener por azar una diferencia tan grande como la observada, o mayor.
| Valor p | Cómo se lee |
|---|---|
| Menor que 0.05 | Diferencia estadísticamente significativa: se rechaza H₀ |
| 0.05 o mayor | No hay evidencia suficiente de diferencia: no se rechaza H₀ |
El 0.05 es una convención, no una frontera natural: p = 0.049 y p = 0.051 dicen casi lo mismo. Por eso conviene reportar la diferencia y su intervalo, además de p. Y el valor p no es la probabilidad de que H₀ sea cierta.
3.6 El volumen de datos importa
Con pocos datos, el EE es grande: una diferencia real puede pasar inadvertida. Con muchos, el EE se reduce y la prueba detecta diferencias más pequeñas. Compruébalo con datos simulados.
Prueba ¿Azar o diferencia real? Cada punto es un estudio simulado que compara dos grupos. El punto se resalta cuando el intervalo de confianza del estudio no incluye el 0. Cambia el número de datos y la diferencia real, y toma más estudios.
Este recuadro necesita JavaScript activado en el navegador.
3.7 Lo que una prueba no dice
«No hay evidencia» no es «son iguales». Un p alto, sobre todo con pocos datos, sólo dice que no se pudo detectar una diferencia.
Significativa no es causal. Si los grupos difieren en algo más, como la temperatura, esa variable de confusión podría explicar parte de la diferencia. Sólo un experimento con asignación al azar separa mejor las causas.
Significativa no es importante. Con muchos datos, una diferencia diminuta sale significativa. Hay que preguntar si vale la pena en t/ha, en dinero o en riesgo.
Qué supone la prueba t. Los datos de cada grupo son independientes entre sí y tienen una forma aproximadamente normal; con grupos grandes, este segundo punto pesa menos. Por eso primero se miran los datos con una gráfica. Para comparar más de dos grupos se usa otra prueba, el análisis de varianza (ANOVA).
4. Ejemplo resuelto: dos dietas para tilapia
Este ejemplo sólo se lee. Un productor probó dos dietas en 30 estanques de tilapia, 15 con cada una, y registró el peso medio final por estanque (datos didácticos). ¿Alguna dieta da un peso distinto?
Paso 1 · Plantear las hipótesis. H₀: el peso medio es igual con ambas dietas. H₁: es distinto.
Paso 2 · Leer los datos y verlos. Una caja muestra la mediana (línea gruesa) y dónde queda la mitad central de los datos.
Script de R
tilapia <- read.csv("ejemplo_tilapia.csv")
boxplot(peso_g ~ dieta, data = tilapia)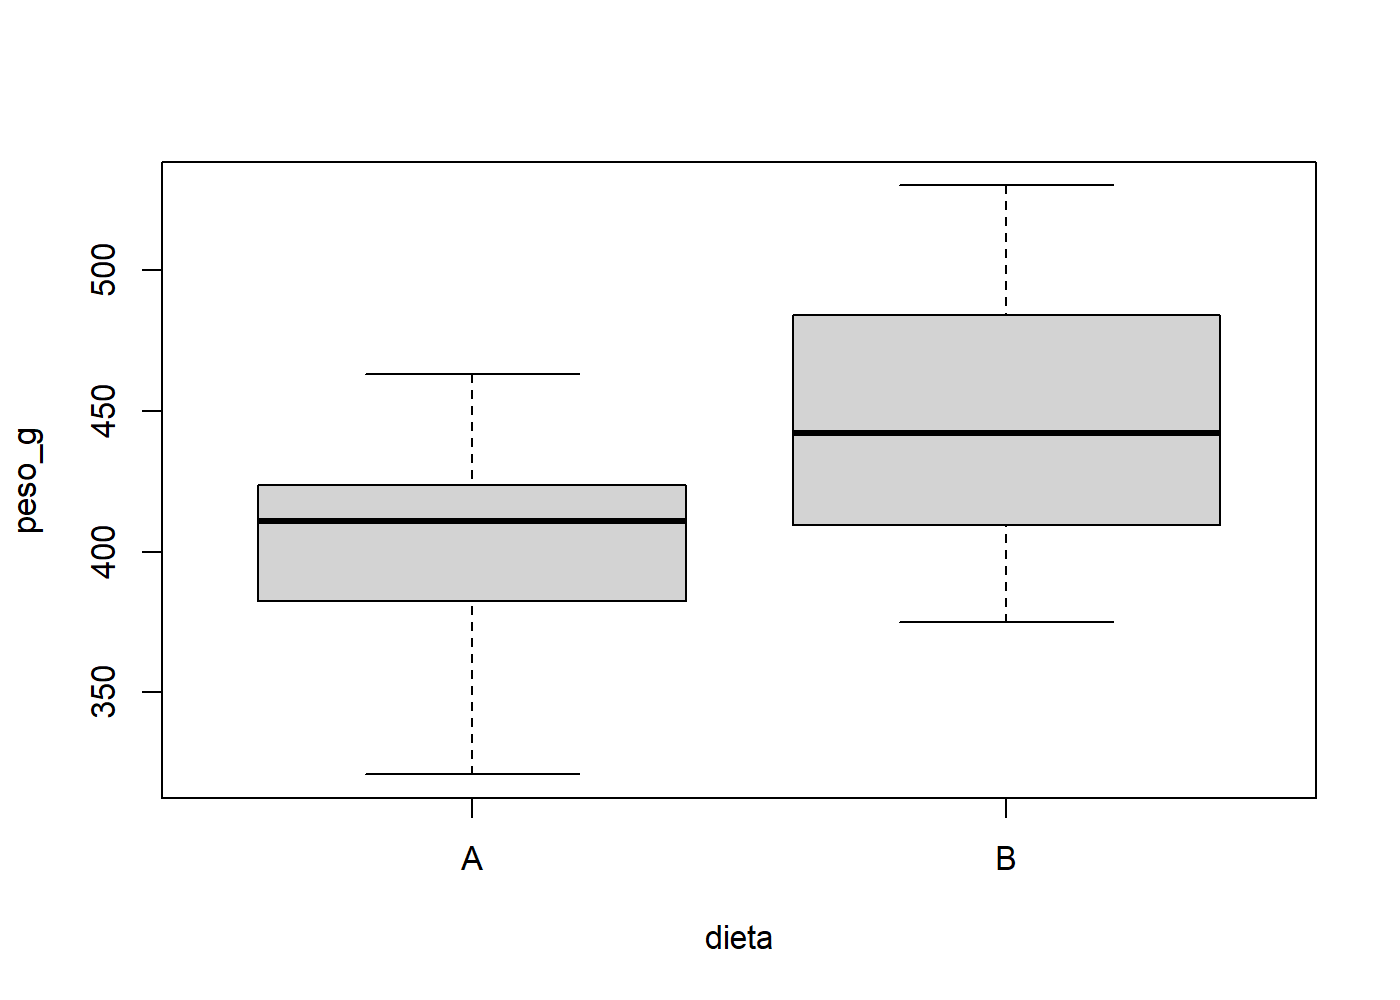
Paso 3 · Hacer la cuenta a mano. Los resúmenes por grupo son:
| Dieta | n | Media (g) | Desviación estándar (g) |
|---|---|---|---|
| A | 15 | 403.7 | 35.0 |
| B | 15 | 448.7 | 47.6 |
- Diferencia (B − A): 448.7 − 403.7 = 45.0 g
- EE = √( 35.0²/15 + 47.6²/15 ) = √( 81.7 + 151.1 ) = √232.8 = 15.3 g
- t = 45.0 ÷ 15.3 = 2.94
Paso 4 · Ejecutar la prueba. t.test() hace la misma cuenta y agrega el intervalo y el valor p.
Script de R
t.test(peso_g ~ dieta, data = tilapia)R contesta en la consola
    Welch Two Sample t-test

data:  peso_g by dieta
t = -2.9445, df = 25.689, p-value = 0.006781
alternative hypothesis: true difference in means between group A and group B is not equal to 0
95 percent confidence interval:
 -76.31924 -13.54742
sample estimates:
mean in group A mean in group B
       403.7333        448.6667
Paso 5 · Leer la salida.
| En la salida | Valor | Qué significa |
|---|---|---|
t |
−2.94 | Coincide con la cuenta a mano. Es negativo porque R calcula A − B |
df |
25.7 | Grados de libertad: los usa R para obtener p y el multiplicador |
p-value |
0.0068 | Menor que 0.05: difícil de atribuir al azar |
95 percent confidence interval |
−76.3 a −13.5 | Para A − B. No incluye el 0 |
sample estimates |
403.7 y 448.7 | Las dos medias |
Paso 6 · Escribir la conclusión. Lleva la diferencia, el intervalo, el valor p, los datos usados y un límite:
Los estanques con la dieta B terminaron en promedio 45 g más pesados que con la dieta A (IC 95 %: 14 a 76 g; p = 0.007; 15 estanques por dieta). La diferencia es estadísticamente significativa, pero el intervalo es amplio. Antes de cambiar de dieta hay que comparar su costo con el valor de esos gramos.
5. Ejercicios en papel
Necesitas calculadora y cuaderno. Intenta cada ejercicio antes de abrir la respuesta.
Ejercicio 1 · Las 8 parcelas del socio, a mano
| Siembra | Rendimiento (t/ha) | Media | Desviación estándar |
|---|---|---|---|
| Temprana | 7.20 · 6.40 · 5.90 · 6.80 | ? | 0.56 |
| Tardía | 7.50 · 6.10 · 7.06 · 7.17 | ? | 0.60 |
- Escribe H₀ y H₁.
- Calcula las dos medias y la diferencia temprana − tardía.
- Calcula el EE y t.
- ¿Te parece que estos datos bastan para recomendar sembrar tarde? Justifica con t.
Ejercicio 2 · Leer una salida de R
Se comparó el peso de lechuga cultivada en dos sustratos, con 10 plantas por sustrato (datos didácticos):
R contesta en la consola
    Welch Two Sample t-test

data:  peso_g by sustrato
t = -0.25704, df = 14.244, p-value = 0.8008
alternative hypothesis: true difference in means between group fibra and group turba is not equal to 0
95 percent confidence interval:
 -31.72499  24.92499
sample estimates:
mean in group fibra mean in group turba
222.5 225.9- ¿Cuánto vale la diferencia fibra − turba, con unidades?
- ¿El intervalo incluye el 0? ¿Qué quiere decir?
- ¿Cuál es el valor p y qué decisión se toma sobre H₀?
- Un compañero concluye: «los dos sustratos son iguales». ¿Cómo lo corregirías?
Ejercicio 3 · Revisar afirmaciones
Di si cada afirmación es correcta. Si no lo es, corrígela.
- «p = 0.03 significa que hay 3 % de probabilidad de que H₀ sea cierta.»
- «Si el IC 95 % de una diferencia va de 0.2 a 0.9 t/ha, la diferencia es significativa al 5 %.»
- «La diferencia fue significativa, así que el tratamiento la causó.»
- «Con 50 000 registros, p < 0.001, por lo tanto la diferencia es grande.»
6. Práctica en R
Ahora vas a repetir la comparación del trigo en R, primero con 8 parcelas y luego con 400.
Carpeta IBS-MDO-Tema-II3 en Google Drive · script y datos
Descárgala completa con el botón de descarga de Drive («Descargar todo»). Drive la baja en un .zip: en Descargas, haz clic derecho → Extraer todo y trabaja dentro de la carpeta extraída.
| Archivo | Para qué |
|---|---|
tema_II3.Rproj |
Abre RStudio trabajando en esta carpeta. Siempre empieza con doble clic aquí. |
Tema_II3_script.R |
El script con los bloques que vas a ejecutar. |
trigo_4_y_4.csv |
Las 8 parcelas del Ejercicio 1. |
trigo_parcelas.csv |
La copia revisada de la libreta: 400 parcelas. |
ejemplo_tilapia.csv |
Los datos del ejemplo resuelto, por si quieres repetirlo. |
- Extrae la carpeta, haz doble clic en
tema_II3.Rprojy abreTema_II3_script.Rdesde el panel Files. - Bloques 1 a 3. Ejecuta la prueba con 4 contra 4. Compara t con tu Ejercicio 1 y anota el intervalo y p.
- Bloques 4 a 6. Repite con 400 parcelas. Anota cuántas hay de cada siembra, las medias, el intervalo y p.
- Escribe la diferencia temprana − tardía y su intervalo. Recuerda que R calcula tardía − temprana.
- Bloque 7. Compara la temperatura de llenado de los dos grupos. ¿Qué limitación agrega a tu conclusión?
- Con un precio supuesto de $6 000 por tonelada, ¿cuánto dinero representa la diferencia por hectárea?
- Escribe tu conclusión con la estructura del Paso 6 del ejemplo.
- Bloque 8. Borra el
#de cada línea, ejecútala, lee el mensaje de R y escribe la línea correcta.
Si R marca un error
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
grouping factor must have exactly 2 levels |
La columna a la derecha de ~ no tiene exactamente dos grupos. |
Revisa el orden de las columnas y los códigos con table(). |
objeto 'rendimiento_t_ha' no encontrado |
R no sabe en qué tabla está la columna. | Agrega data = datos. |
objeto 'datos' no encontrado |
No has ejecutado la línea que crea la tabla. | Ejecuta primero el Bloque 4. |
no se puede abrir la conexión (cannot open file) |
R no encuentra el archivo. | Abre RStudio con doble clic en tema_II3.Rproj, en la carpeta extraída. |
| No veo la gráfica | Las gráficas salen en el panel Plots. | Haz clic en la pestaña Plots, abajo a la derecha. |
7. ¿Lo entendiste?
Cuatro preguntas rápidas Elige una respuesta para ver la explicación; puedes volver a intentar.
1. Dos grupos tienen la misma diferencia de medias. ¿En qué caso es más probable que la prueba sea significativa?
- Pocos datos y mucha dispersión
- Muchos datos y poca dispersión
- Da igual: sólo importa la diferencia
Con muchos datos y poca dispersión, el error estándar es pequeño y t crece. La misma diferencia pesa más cuando hay menos ruido.
2. El IC 95 % de una diferencia va de −1.2 a 0.4 t/ha. ¿Qué concluyes?
- El primer grupo rinde 1.2 t/ha menos
- Los dos grupos son iguales
- No hay evidencia suficiente de una diferencia
El intervalo incluye el 0, así que no se puede descartar que no haya diferencia. Tampoco prueba que sean iguales: diferencias de hasta 1.2 t/ha siguen siendo compatibles con los datos.
3. Las parcelas con riego por goteo rindieron más (p = 0.01), pero también son las de suelos mejores. ¿Qué es el suelo aquí?
- Una posible variable de confusión
- El valor p
- La hipótesis nula
El suelo difiere entre los grupos y también puede afectar al rendimiento. Por eso la prueba no permite atribuir toda la diferencia al goteo.
4. ¿Qué dice el error estándar de la diferencia?
- Cuánto varían las parcelas dentro de cada grupo
- Cuánto se movería la diferencia de medias de un estudio a otro
- La probabilidad de que H₀ sea cierta
Lo primero lo dice la desviación estándar. El error estándar se refiere a la estimación de la diferencia y baja cuando hay más datos.
Instrucciones de R de este tema
| Instrucción | Qué hace | En Excel sería |
|---|---|---|
boxplot(y ~ grupo, data = datos) |
Dibuja una caja por grupo | Insertar → Cajas y bigotes |
t.test(y ~ grupo, data = datos) |
Prueba t entre dos grupos: t, intervalo, p y medias | PRUEBA.T(rango1, rango2, 2, 3), sólo para p |