Distribución normal
Histograma, desviación estándar, regla 68-95-99.7 y puntuación z
2026-10-19
Sesión 02 · Unidad II · Calidad de la información
Distribución normal
Histograma, desviación estándar, regla 68-95-99.7 y puntuación z
¿Qué es normal y qué es raro?
El tema de hoy
En la sesión 1 revisaste la libreta, corregiste lo que tenía evidencia y dejaste fuera lo imposible. Quedó una copia de trabajo con 400 parcelas y un rendimiento típico. Pero un número típico no dice qué tan lejos de él es normal quedar. Hoy vas a ver la forma de los datos con un histograma, a medir qué tan repartidos están con la desviación estándar y a usar la distribución normal para tener una regla que marque las parcelas raras sin revisarlas una por una.
Ya vimos · Sesión 01 Leer y revisar datos con R Media, mediana y bitácora
Hoy · Sesión 02 Distribución normal ¿Qué es normal y qué es raro?
Después · Sesión 03 Prueba estadística ¿Conviene sembrar temprano?
Al terminar la sesión podrás:
- Leer un histograma y describir la forma de los datos: dónde está el pico y si es simétrica o cargada a un lado.
- Interpretar la desviación estándar con su unidad y comprobar la regla 68-95-99.7 con datos reales.
- Calcular la puntuación z a mano y en R, y usarla para marcar los datos que hay que revisar.
- Reconocer cuándo la regla normal no sirve: datos con forma cargada a un lado.
- Explicar por qué en ciencia de datos y big data se usan reglas sobre la distribución en lugar de revisar fila por fila.
Palabras clave histograma forma distribución normal campana desviación estándar regla 68-95-99.7 puntuación z dato raro forma sesgada big data
1. Un problema para empezar: dos socios preguntan
Con la libreta revisada, la asociación empezó a contestar las preguntas de sus socios. Llegaron dos casi al mismo tiempo:
Parcela P027 9.18 t/ha «¿Mi parcela es extraordinaria o hubo un error en la báscula?»
Parcela P346 4.08 t/ha «¿Por qué me fue tan mal? ¿Mi parcela es un caso raro?»
La pregunta de hoy: ¿qué es normal en el valle y qué parcelas son raras?
Las dos son posibles: el trigo del valle rinde entre 4 y 9 t/ha. Ninguna es un error obvio como el 68.70 t/ha de la sesión 1. Para contestar hace falta saber qué tan lejos de la media es normal quedar y a partir de qué distancia una parcela ya es rara. La asociación también quiere una regla que pueda aplicar cada ciclo, cuando lleguen otras 400 parcelas.
2. Por qué no basta con lo que hiciste en la sesión 1
La media y la mediana dicen dónde está el centro, pero no qué tan repartidos están los datos. Mira dos grupos de cinco parcelas con la misma media:
| Grupo | Rendimientos (t/ha) | Media |
|---|---|---|
| A | 6.6 · 6.7 · 6.8 · 6.9 · 7.0 | 6.8 t/ha |
| B | 5.2 · 6.0 · 6.8 · 7.6 · 8.4 | 6.8 t/ha |
En el grupo A, una parcela de 8.4 t/ha sería rarísima; en el grupo B es una más. Para decir si un dato es raro hay que medir la dispersión de los datos y conocer su forma.
Además, en la sesión 1 los errores se encontraron con summary(), mirando el mínimo y el máximo. Eso funciona con valores imposibles, pero no con valores posibles y poco comunes. Con 400 parcelas todavía se puede revisar a ojo; con miles de registros, ya no.
3. Dónde vas a usar esto
Acuicultura. Un sensor que mide el oxígeno de un estanque cada 15 minutos produce 96 lecturas al día y unas 35 000 al año, por estanque. Una regla como |z| > 3 marca sola las lecturas que hay que mirar. Es el ejemplo resuelto de la sección 4.6.
Agricultura de precisión. Las imágenes de satélite o de dron dan un valor de vigor para cada pixel: millones de datos por lote. Las zonas con z muy bajo son las que se revisan en campo.
Control de calidad. En una empacadora, el peso de cada caja se compara con la media y la desviación del proceso; las cajas a más de 3 desviaciones se apartan. Así funcionan las gráficas de control.
Producción animal. El peso de un lote se compara con lo normal para su edad; un lote a más de 2 desviaciones abajo se revisa: alimento, agua, salud.
Tu informe y tu examen. En el informe con datos de camarón y en el examen con datos de becerros vas a usar la misma regla.
400 parcelas no son big data, pero las ideas son las mismas. Lo que cambia es la escala: con millones de registros, la única forma de revisar es con reglas escritas en un script.
4. La distribución normal
4.1 El histograma: la forma de los datos
Un histograma reparte los datos en intervalos del mismo ancho y dibuja una barra por intervalo; la altura de la barra es cuántos datos caen ahí. Así se ve la forma completa de los datos, algo que ni la media ni la mediana muestran.
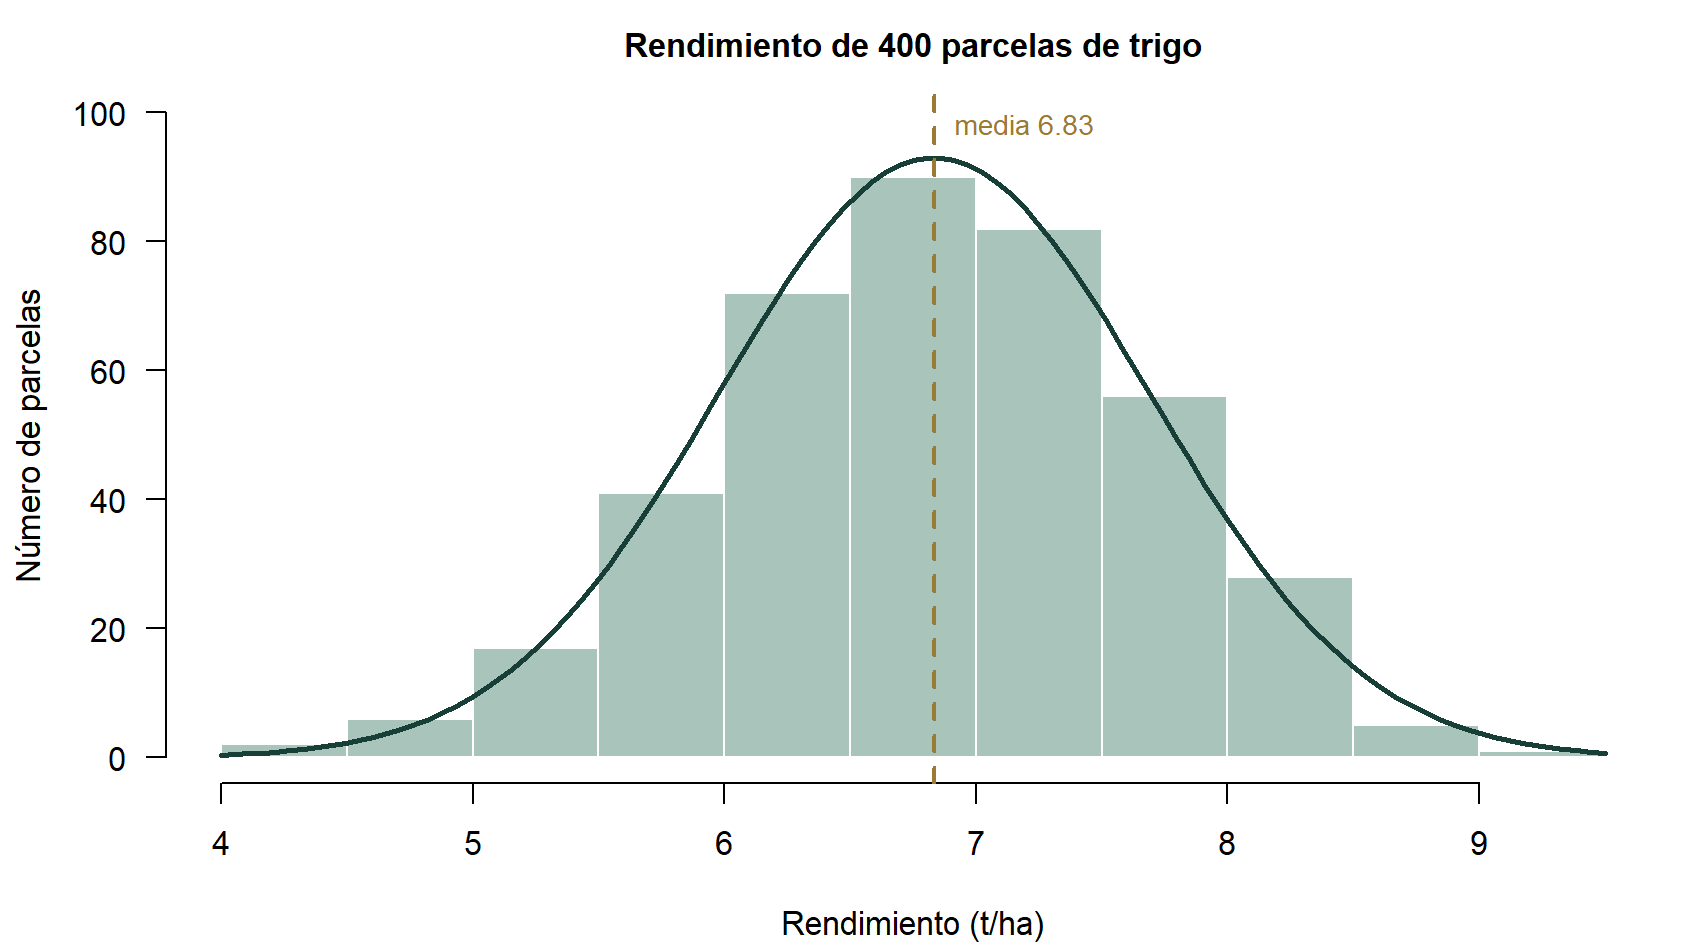
Se lee así: hay un solo pico, entre 6.5 y 7 t/ha; a los dos lados las barras bajan parejo, y muy pocas parcelas quedan abajo de 5 o arriba de 8.5 t/ha. Esa forma de campana, simétrica y con un solo pico, es muy común en datos biológicos: alturas, pesos, rendimientos.
Con las 8 parcelas de la sesión 1, cada barra tendría una o dos parcelas y no se vería ninguna forma. Hacen falta decenas o cientos de datos para saber si hay campana.
4.2 La desviación estándar: qué tan repartidos están los datos
La desviación estándar (s) mide a qué distancia de la media suelen quedar los datos. Usa todos los datos: mide la distancia de cada uno a la media, la eleva al cuadrado, promedia esos cuadrados dividiendo entre n − 1 y saca la raíz. Excel la calcula con DESVEST.M y R con sd().
s = √[ Σ (dato − media)² ÷ (n − 1) ]
En la copia revisada, s = 0.86 t/ha: una parcela típica queda a unos 0.86 t/ha de la media. Va en las mismas unidades que los datos.
4.3 La curva normal y la regla 68-95-99.7
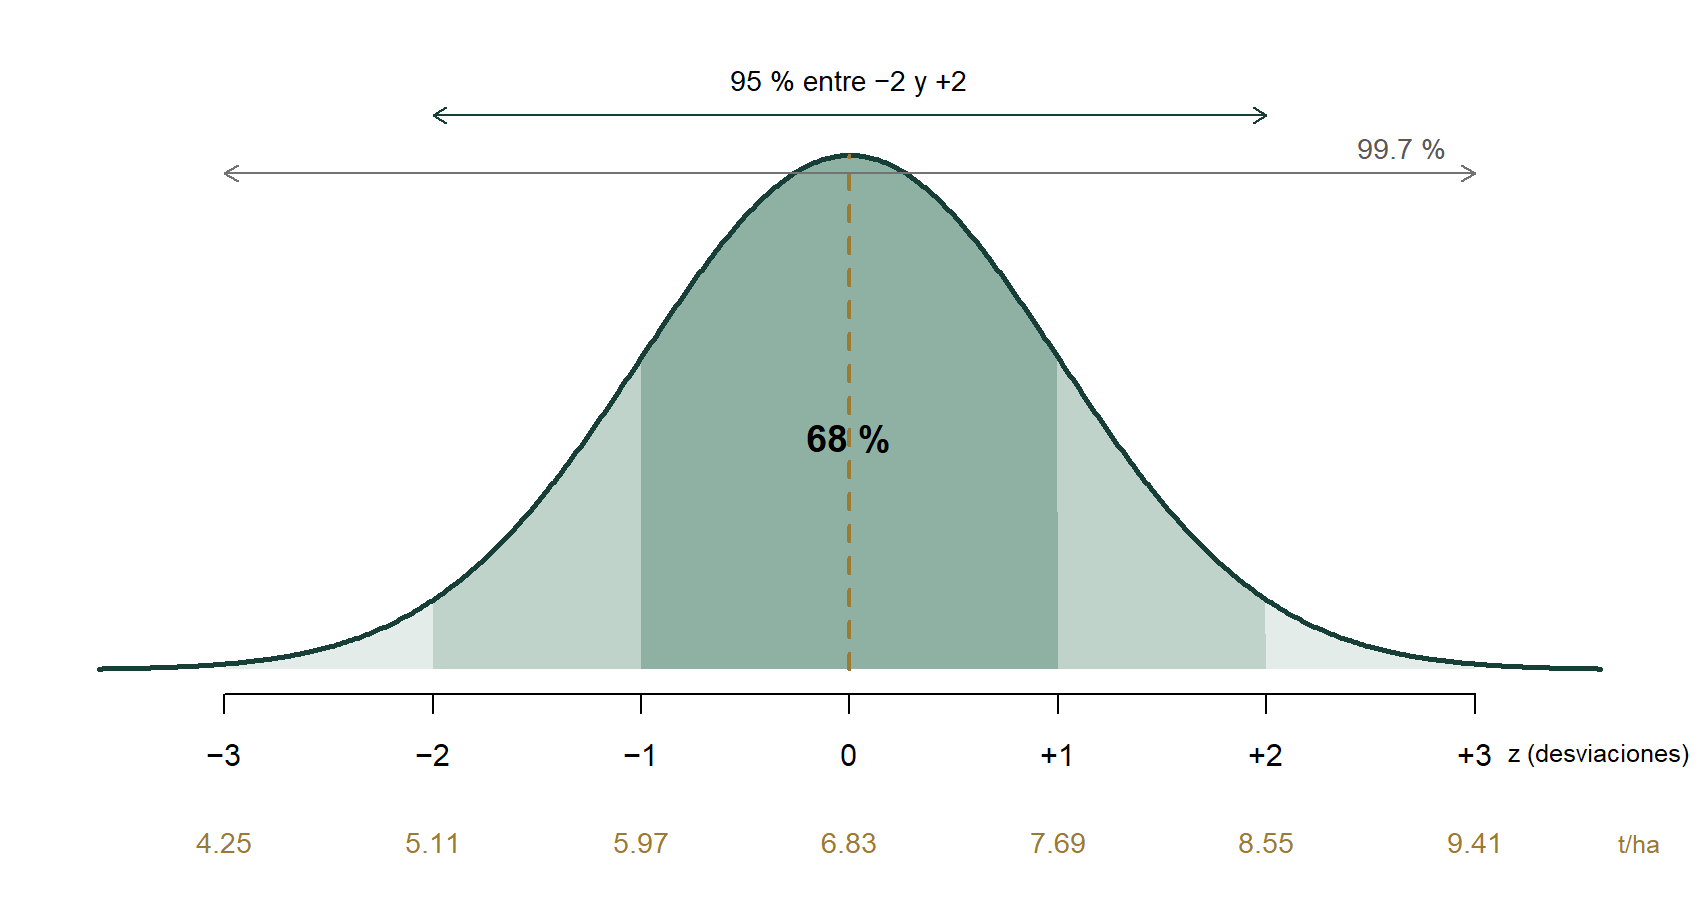
La distribución normal es un modelo matemático de la forma de campana. Sólo necesita dos números: la media, que dice dónde está el centro, y la desviación estándar, que dice qué tan ancha es la campana. Cuando los datos tienen esa forma, se cumple esta regla:
Regla 68-95-99.7
Aproximadamente el 68 % de los datos queda a 1 desviación estándar de la media; el 95 %, a 2, y el 99.7 %, a 3.
| Distancia a la media | Intervalo del rendimiento | La regla dice que ahí queda |
|---|---|---|
| 1 desviación | 6.83 ± 0.86: de 5.97 a 7.69 t/ha | el 68 % de las parcelas |
| 2 desviaciones | 6.83 ± 1.72: de 5.11 a 8.55 t/ha | el 95 % |
| 3 desviaciones | 6.83 ± 2.58: de 4.25 a 9.41 t/ha | el 99.7 % |
¿Se cumple con las 400 parcelas? Lo vas a comprobar en el Ejercicio 3: R cuenta cuántas quedan en cada intervalo y tú calculas el porcentaje. Antes, pruébalo con otros datos:
Prueba ¿Se cumple la regla con estos datos? Mueve el control para ensanchar la franja de la media ± k desviaciones y compara el porcentaje de los datos con el de la curva normal. Después cambia a la otra variable, que no tiene forma de campana.
Este recuadro necesita JavaScript activado en el navegador.
4.4 La puntuación z: a cuántas desviaciones está un dato
z = (dato − media) ÷ desviación estándar
z dice a cuántas desviaciones estándar de la media está un dato y de qué lado: positivo arriba de la media, negativo abajo. No tiene unidades.
Ejemplo. Una parcela de 8.2 t/ha: z = (8.2 − 6.83) ÷ 0.86 = 1.37 ÷ 0.86 = 1.59. Una de 4.5 t/ha: z = (4.5 − 6.83) ÷ 0.86 = −2.33 ÷ 0.86 = −2.71. Para clasificar se mira |z|, el valor sin signo:
| |z| | Qué tan común es (si la forma es de campana) | Qué se hace |
|---|---|---|
| Hasta 1 | Típico: ahí está cerca del 68 % de los datos | Nada |
| Entre 1 y 2 | Común: con estos se completa el 95 % | Nada |
| Entre 2 y 3 | Poco común: sólo cerca del 5 % queda más allá de 2 | Mirarlo, sin alarma |
| Más de 3 | Muy raro: sólo 3 de cada 1 000 datos | Revisar el registro |
Prueba Calcula z de un camarón En una cosecha de camarón el peso medio es 20 g y la desviación estándar 2.5 g. Mueve el peso y mira dónde cae en la campana.
Este recuadro necesita JavaScript activado en el navegador.
Revisar no es borrar. Un dato con |z| > 3 puede ser un error de captura, un sensor que falló o un caso real extraordinario. Se busca el registro y se decide como en la bitácora de la sesión 1: corregir sólo con evidencia, dejar fuera de la copia de trabajo o conservar.
4.5 Cuándo la regla no sirve
La regla 68-95-99.7 y el criterio |z| > 3 suponen forma de campana. Si los datos están cargados a un lado, la regla se equivoca. Pasa con la superficie de las parcelas: muchas son chicas y unas pocas son muy grandes.
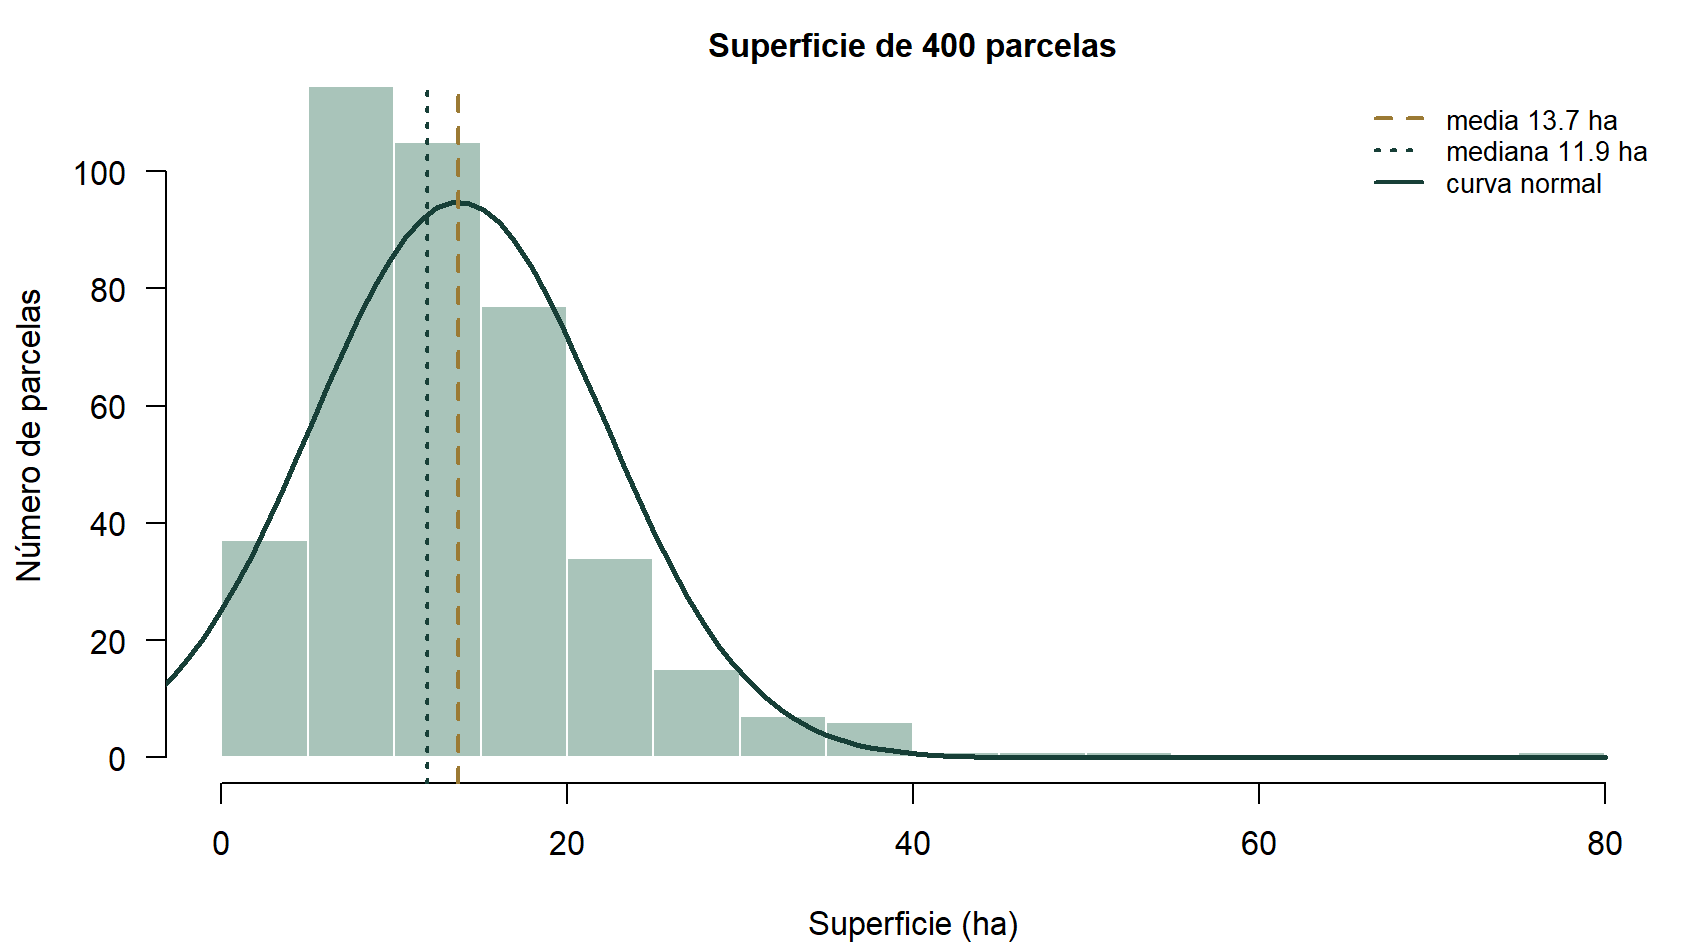
Con una forma así, la media queda arriba de la mediana (las parcelas grandes la jalan) y los z grandes salen siempre del mismo lado. En el Ejercicio 4 verás qué pasa si de todos modos se aplica la regla. Por eso, antes de usar la regla, se mira el histograma.
4.6 Ejemplo resuelto: el sensor de oxígeno de un estanque
Un sensor midió el oxígeno disuelto de un estanque de camarón cada 15 minutos, de las 22:00 a las 3:45: 24 lecturas (datos didácticos). El archivo ejemplo_oxigeno.csv está en tu carpeta. ¿Hay lecturas que revisar?
Paso 1 · Leer los datos y verlos.
Escribes en el script · Ctrl + Enter
oxigeno <- read.csv("ejemplo_oxigeno.csv")
head(oxigeno)
R contesta en la consola
  lectura  hora oxigeno_mg_l
1       1 22:00          5.6
2       2 22:15          5.8
3       3 22:30          5.5
4       4 22:45          5.7
5       5 23:00          5.9
6       6 23:15          5.4
Paso 2 · Elegir la columna, centro y dispersión. x guarda la columna con un nombre corto; media y desv quedan guardadas para el paso 4.
Escribes en el script · Ctrl + Enter
x <- oxigeno$oxigeno_mg_l
media <- mean(x)
media
median(x)
desv <- sd(x)
desv
R contesta en la consola
[1] 5.3125
[1] 5.5
[1] 1.062529
La media (5.31 mg/L) queda abajo de la mediana (5.5 mg/L): algo la jala hacia abajo. La desviación, 1.06 mg/L, es muy grande para un sensor que casi siempre marca entre 5.2 y 5.9 mg/L.
Paso 3 · Ver la forma. hist(x) dibuja el histograma en el panel Plots. R le pone el título «Histogram of x».
Escribes en el script · Ctrl + Enter
hist(x)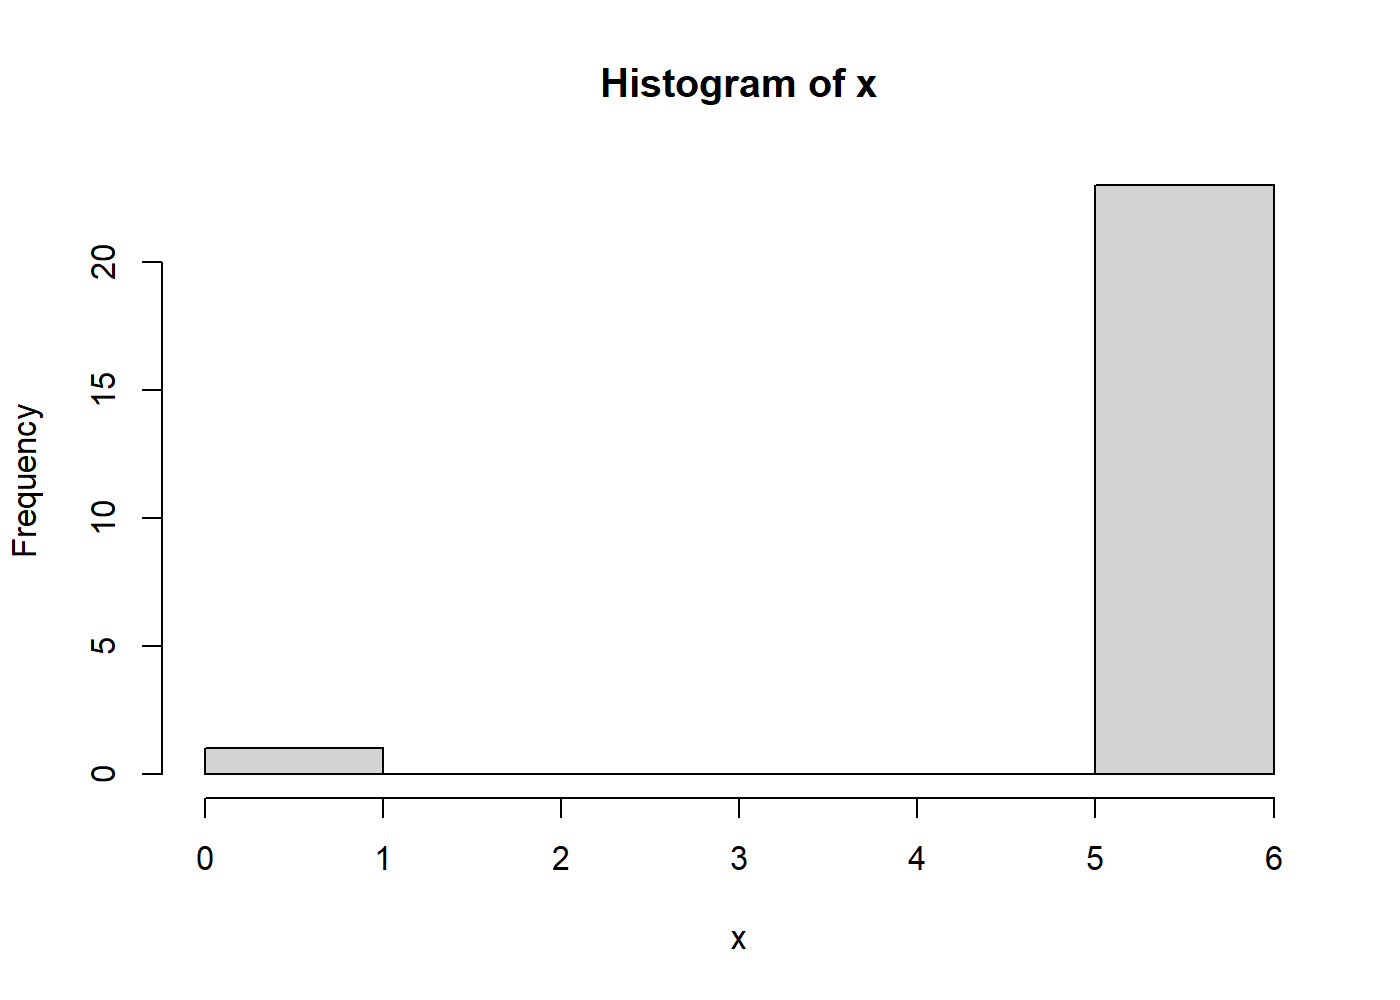
Paso 4 · Calcular z y marcar las lecturas raras. La primera línea crea la columna z para las 24 lecturas: es la fórmula de la sección 4.4 arrastrada, como en Excel. abs() quita el signo e ifelse() es el SI de Excel.
Escribes en el script · Ctrl + Enter
oxigeno$z <- (x - media) / desv
oxigeno$revisar <- ifelse(abs(oxigeno$z) > 3, "revisar", "ok")
table(oxigeno$revisar)
R contesta en la consola
     ok revisar
     23       1
Paso 5 · Encontrar la lectura y decidir. En View(oxigeno), al ordenar la columna z aparece primero la lectura 12 (00:45): 0.4 mg/L, con z = −4.62. Quince minutos antes el sensor marcaba 5.4 mg/L y quince minutos después, 5.6 mg/L: el agua no pierde y recupera el oxígeno así de rápido. Es una falla del sensor. Se deja fuera de la copia de trabajo y se anota en la bitácora. Sin ella, la media es 5.53 mg/L y la desviación 0.19 mg/L: el error, además, inflaba la desviación.
4.7 Lo que se gana y lo que se pierde
Con la media, la desviación estándar y z ya tienes una regla para decir qué es normal y qué es raro, y se aplica igual a 400 parcelas que a un millón de lecturas. Pero z mira un dato a la vez. La asociación también pregunta si conviene sembrar temprano: eso compara dos grupos de parcelas, y una diferencia entre sus promedios podría deberse al azar. En la sesión 3 usarás una prueba estadística para decidirlo.
¿Lo entendiste? Cuatro preguntas rápidas No cuentan para la calificación. Elige una respuesta para ver la explicación; puedes volver a intentar.
1. En un lote de becerros el peso medio es 210 kg y la desviación estándar 20 kg. Un becerro pesa 250 kg. ¿Cuál es su z?
- 2
- 40
- 1.19
z = (250 − 210) ÷ 20 = 40 ÷ 20 = 2. El becerro está a 2 desviaciones estándar arriba de la media. 40 kg es la diferencia en kilos, todavía sin dividir; 1.19 sale de dividir 250 entre 210, que no mide nada útil.
2. Si los datos tienen forma de campana, ¿qué parte queda entre la media − 2s y la media + 2s?
- Cerca del 68 %
- Cerca del 95 %
- Cerca del 99.7 %
Es la regla 68-95-99.7: a 1 desviación queda cerca del 68 %, a 2 desviaciones cerca del 95 % y a 3 desviaciones casi todo, el 99.7 %.
3. Una lectura de un sensor tiene z = −3.4. ¿Qué haces?
- Borrarla: con |z| > 3 es un error
- Revisar el registro antes de decidir
- Nada: un z negativo es normal
|z| = 3.4 es más de 3: muy raro si los datos tienen forma de campana. Pero raro no quiere decir error. Se revisa: puede ser una falla del sensor, un error de captura o un caso real. La decisión se anota en la bitácora; el dato no se borra del original.
4. El histograma de una variable está cargado a la izquierda, con una cola larga a la derecha. ¿Sirve la regla |z| > 3 para encontrar datos raros?
- Sí, sirve con cualquier forma
- No tal cual: la regla supone forma de campana
- Sólo si hay más de 100 datos
La regla 68-95-99.7 y el criterio |z| > 3 vienen de la curva normal. Con una forma cargada a un lado, la regla marca como raros datos que son normales para esa variable, y todos del mismo lado, como pasa con la superficie de las parcelas. Tener muchos datos no arregla la forma.
5. Lo que harás hoy
Carpeta IBS-MDO-U2-Sesion2 en Google Drive · script, datos, Excel y lectura en PDF
Descárgala completa con el botón de descarga de Drive («Descargar todo»). Drive la baja en un .zip: en Descargas, haz clic derecho → Extraer todo y trabaja dentro de la carpeta extraída. El Excel se guarda con tu apellido y nombre; escribe sólo en las celdas amarillas.
| Archivo | Para qué |
|---|---|
sesion2.Rproj |
Abre RStudio trabajando en esta carpeta. Siempre empieza con doble clic aquí. |
Sesion2_script.R |
El script con los bloques que vas a ejecutar. |
Sesion 2 - Ejercicios.xlsx |
Donde contestas. Tiene cuatro hojas. |
trigo_parcelas.csv |
La copia revisada de la libreta: 400 parcelas. |
ejemplo_oxigeno.csv |
Los datos del ejemplo de la sección 4.6. |
Si das doble clic a sesion2.Rproj dentro del .zip, RStudio se abre pero no encuentra el script ni los CSV. Cierra RStudio, extrae la carpeta y abre el .Rproj de la carpeta extraída.
La puntuación z a mano · hoja 1_A_mano · 15 min
Caso: las parcelas de los dos socios y otras tres. Con la media (6.83 t/ha) y la desviación estándar (0.86 t/ha) de la copia revisada, calculas z de cinco parcelas y decides cuáles son raras.
Para qué te sirve hacerlo a mano. Con cinco datos ves de dónde sale cada z. Después R hará la misma cuenta para 400 parcelas en una sola línea y la podrás comprobar con tus números.
- Escribe tu nombre y la fecha.
- Calcula los intervalos media ± s y media ± 2s (1.1).
- Para cada parcela resta la media: dato − 6.83. Cuida el signo.
- Divide entre 0.86: es z. Redondea a dos decimales.
- Clasifica cada parcela con la tabla de la sección 4.4 (lista desplegable) (1.2).
- Contesta qué le dirías a cada socio (1.3 y 1.4).
Una parcela arriba de la media tiene z positivo; abajo, negativo. Si |z| es menor que 1, la parcela debe caer dentro del intervalo media ± s que calculaste. Si te salen z cercanos a 0.1 o 1.3 para todas, dividiste entre la media y no entre la desviación.
La forma del rendimiento · hoja 2_En_R · 20 min
Caso: la copia revisada, 400 parcelas. Antes de usar cualquier regla se mira la forma de los datos.
- En la carpeta extraída IBS-MDO-U2-Sesion2, haz doble clic en
sesion2.Rprojy abreSesion2_script.Rdesde el panel Files. - Ejecuta los Bloques 1 y 2. Revisa en Environment cuántas filas tiene
datos(2.1). - Bloque 3. Antes de ejecutar, escribe qué media esperas. Después anota la media, la mediana y la desviación estándar con su unidad (2.2 y 2.3).
- Bloque 4. Dibuja en tu cuaderno la forma que esperas y luego ejecuta
hist(x). Describe la forma y di en qué intervalo hay más parcelas (2.4 y 2.5).
La media debe estar cerca de 6.8 t/ha. Si no ves el histograma, búscalo en el panel Plots, abajo a la derecha.
¿Qué parcelas son raras? · hoja 2_En_R · 25 min
Caso: las mismas 400 parcelas. Ahora R calcula z para cada parcela y cuenta cuántas quedan a 1, 2 y 3 desviaciones. Compruebas con datos reales la regla 68-95-99.7 y obtienes la lista de parcelas para revisar.
- Bloque 5. Ejecuta la línea de z y
head(datos). Busca P006 y compara su z con tu Ejercicio 1 (3.1). - Bloque 6. Ejecuta las cuatro líneas. Con lo que dice
table(), calcula el porcentaje: dentro ÷ 400 × 100 (3.2 y 3.3). ¿Se cumple la regla? (3.4). - Bloque 7. Cuenta las parcelas marcadas (3.5). En
View(datos)ordena la columna z con un clic y escribe qué parcelas son, su rendimiento y su z (3.6).
Después del Bloque 5, head(datos) debe mostrar una columna nueva, z. Si el z de P006 es muy distinto del tuyo, revisa los paréntesis de tu cuenta o de la línea.
Otra columna: la superficie · hoja 3_Superficie · 15 min
Caso: la superficie de las mismas parcelas. Es otra columna de la libreta, con una forma muy distinta. Ves qué pasa cuando se aplica la regla normal a datos que no tienen forma de campana, y practicas cambiar una sola palabra del script para analizar otra variable, como harás en el informe y en el examen.
- Regresa al Bloque 2 y cambia
rendimiento_t_haporsuperficie_ha. Sólo eso. - Ejecuta otra vez, en orden, los Bloques 2 a 7.
- Contesta las preguntas 4.1 a 4.6 comparando con el rendimiento.
- Contesta la pregunta final de la sesión (4.7) con lo que encontraste en los Ejercicios 3 y 4.
Después del cambio, la media debe estar en hectáreas, cerca de 14. Si sigue en 6.83, no ejecutaste otra vez el Bloque 3.
Revisar afirmaciones y código · hoja 4_Revisar · 10 min
La situación. Un compañero hizo el mismo análisis y dejó notas y líneas de código. Algunas están bien y otras no. Practicas leer resultados y código, como en la primera parte del examen de la unidad.
- Parte A. Para cada afirmación elige Sí o No en «¿Es correcta?» y, si no lo es, escribe el error y lo correcto (5.1 a 5.4).
- Parte B. Para cada línea escribe qué crees que contestará R y qué está mal. Después compruébalo en el Bloque 8 del script: borra el
#del inicio de la línea y ejecútala (5.5 a 5.7). - Contesta qué cambiarías en el Bloque 2 para analizar otra columna (5.8).
6. Si R marca un error
R puede contestar en español o en inglés, según cómo esté instalado. Las primeras filas son de lo nuevo de hoy.
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
Error en hist.default(datos): 'x' debe ser numérico ('x' must be numeric) |
hist() recibió la tabla completa o una columna mal escrita. | Usa una columna de números: hist(x) o hist(datos$rendimiento_t_ha). |
objeto 'revisar' no encontrado (object 'revisar' not found) |
A una palabra le faltan las comillas: R la toma como el nombre de un objeto. | Escribe la palabra entre comillas: “revisar”. |
| Los z salen enormes (6, 13, 20…) sin ningún error | Faltan los paréntesis: R divide antes de restar. | Escribe (x - media) / desv. |
sd() o mean() dan NA |
La columna tiene faltantes: pasa con la libreta original, no con la copia revisada. | Revisa que leíste trigo_parcelas.csv o usa na.rm = TRUE. |
| No veo el histograma | Las gráficas salen en el panel Plots. | Haz clic en la pestaña Plots, abajo a la derecha. |
objeto 'datos' no encontrado (object 'datos' not found) |
No has ejecutado la línea que crea el objeto o el nombre está mal escrito. | Ejecuta primero el Bloque 1 y revisa la letra exacta. |
no se puede abrir la conexión (cannot open file) |
R no encuentra el archivo. | Abre RStudio con doble clic en sesion2.Rproj de la carpeta extraída. |
La consola muestra + en lugar de > |
La línea quedó incompleta: falta cerrar un paréntesis o unas comillas. | Presiona Esc y vuelve a ejecutar la línea corregida. |
Al guardarlos, Excel puede cambiar las comas por punto y coma y R ya no los lee bien. Si quieres ver los datos, usa View() en R.
7. Antes de entregar
Marca cada punto conforme lo revises. Tus marcas se guardan sólo en este navegador.
Tus instrucciones de R hasta hoy
Esta tarjeta crece en cada sesión. El examen de la unidad sólo usa instrucciones de esta tarjeta. Las de hoy dicen Nueva.
| Instrucción | Qué hace | En Excel sería |
|---|---|---|
<- |
Guarda un resultado con un nombre | Ponerle nombre a una celda o tabla |
read.csv("archivo.csv") |
Lee un archivo de datos | Abrir el archivo |
head(datos) |
Muestra las primeras 6 filas | Mirar el inicio de la hoja |
View(datos) |
Abre la tabla completa; se puede ordenar con clic | Ver la hoja y ordenarla |
datos$columna |
Elige una columna de la tabla | Seleccionar una columna |
summary(datos) |
Mínimo, cuartiles, mediana, media, máximo y faltantes | MIN, CUARTIL, MEDIANA, PROMEDIO, MAX, CONTAR.BLANCO |
table(datos$columna) |
Cuenta cuántas veces aparece cada código o palabra | CONTAR.SI, uno por código |
mean(x, na.rm = TRUE) |
Media sin los faltantes | PROMEDIO |
median(x, na.rm = TRUE) |
Mediana sin los faltantes | MEDIANA |
sd(x) |
Nueva. Desviación estándar | DESVEST.M |
hist(x) |
Nueva. Histograma, en el panel Plots | Insertar → Histograma |
datos$nueva <- … |
Nueva. Crea una columna con una cuenta para cada fila | Escribir una fórmula y arrastrarla |
abs(x) |
Nueva. Quita el signo: |−1.5| = 1.5 | ABS |
ifelse(condición, "sí", "no") |
Nueva. Escribe una cosa si se cumple la condición y otra si no | SI |
Práctica extra (opcional)
¿Quieres practicar para el examen? Aquí aparecen datos de otros biosistemas: calcula a mano la diferencia con la media y z, y clasifica el dato. Si te equivocas, la página te dice en qué paso revisar.
Esta práctica necesita JavaScript activado en el navegador.